李宏毅机器学习 (3)误差和梯度下降
Optimization Fails
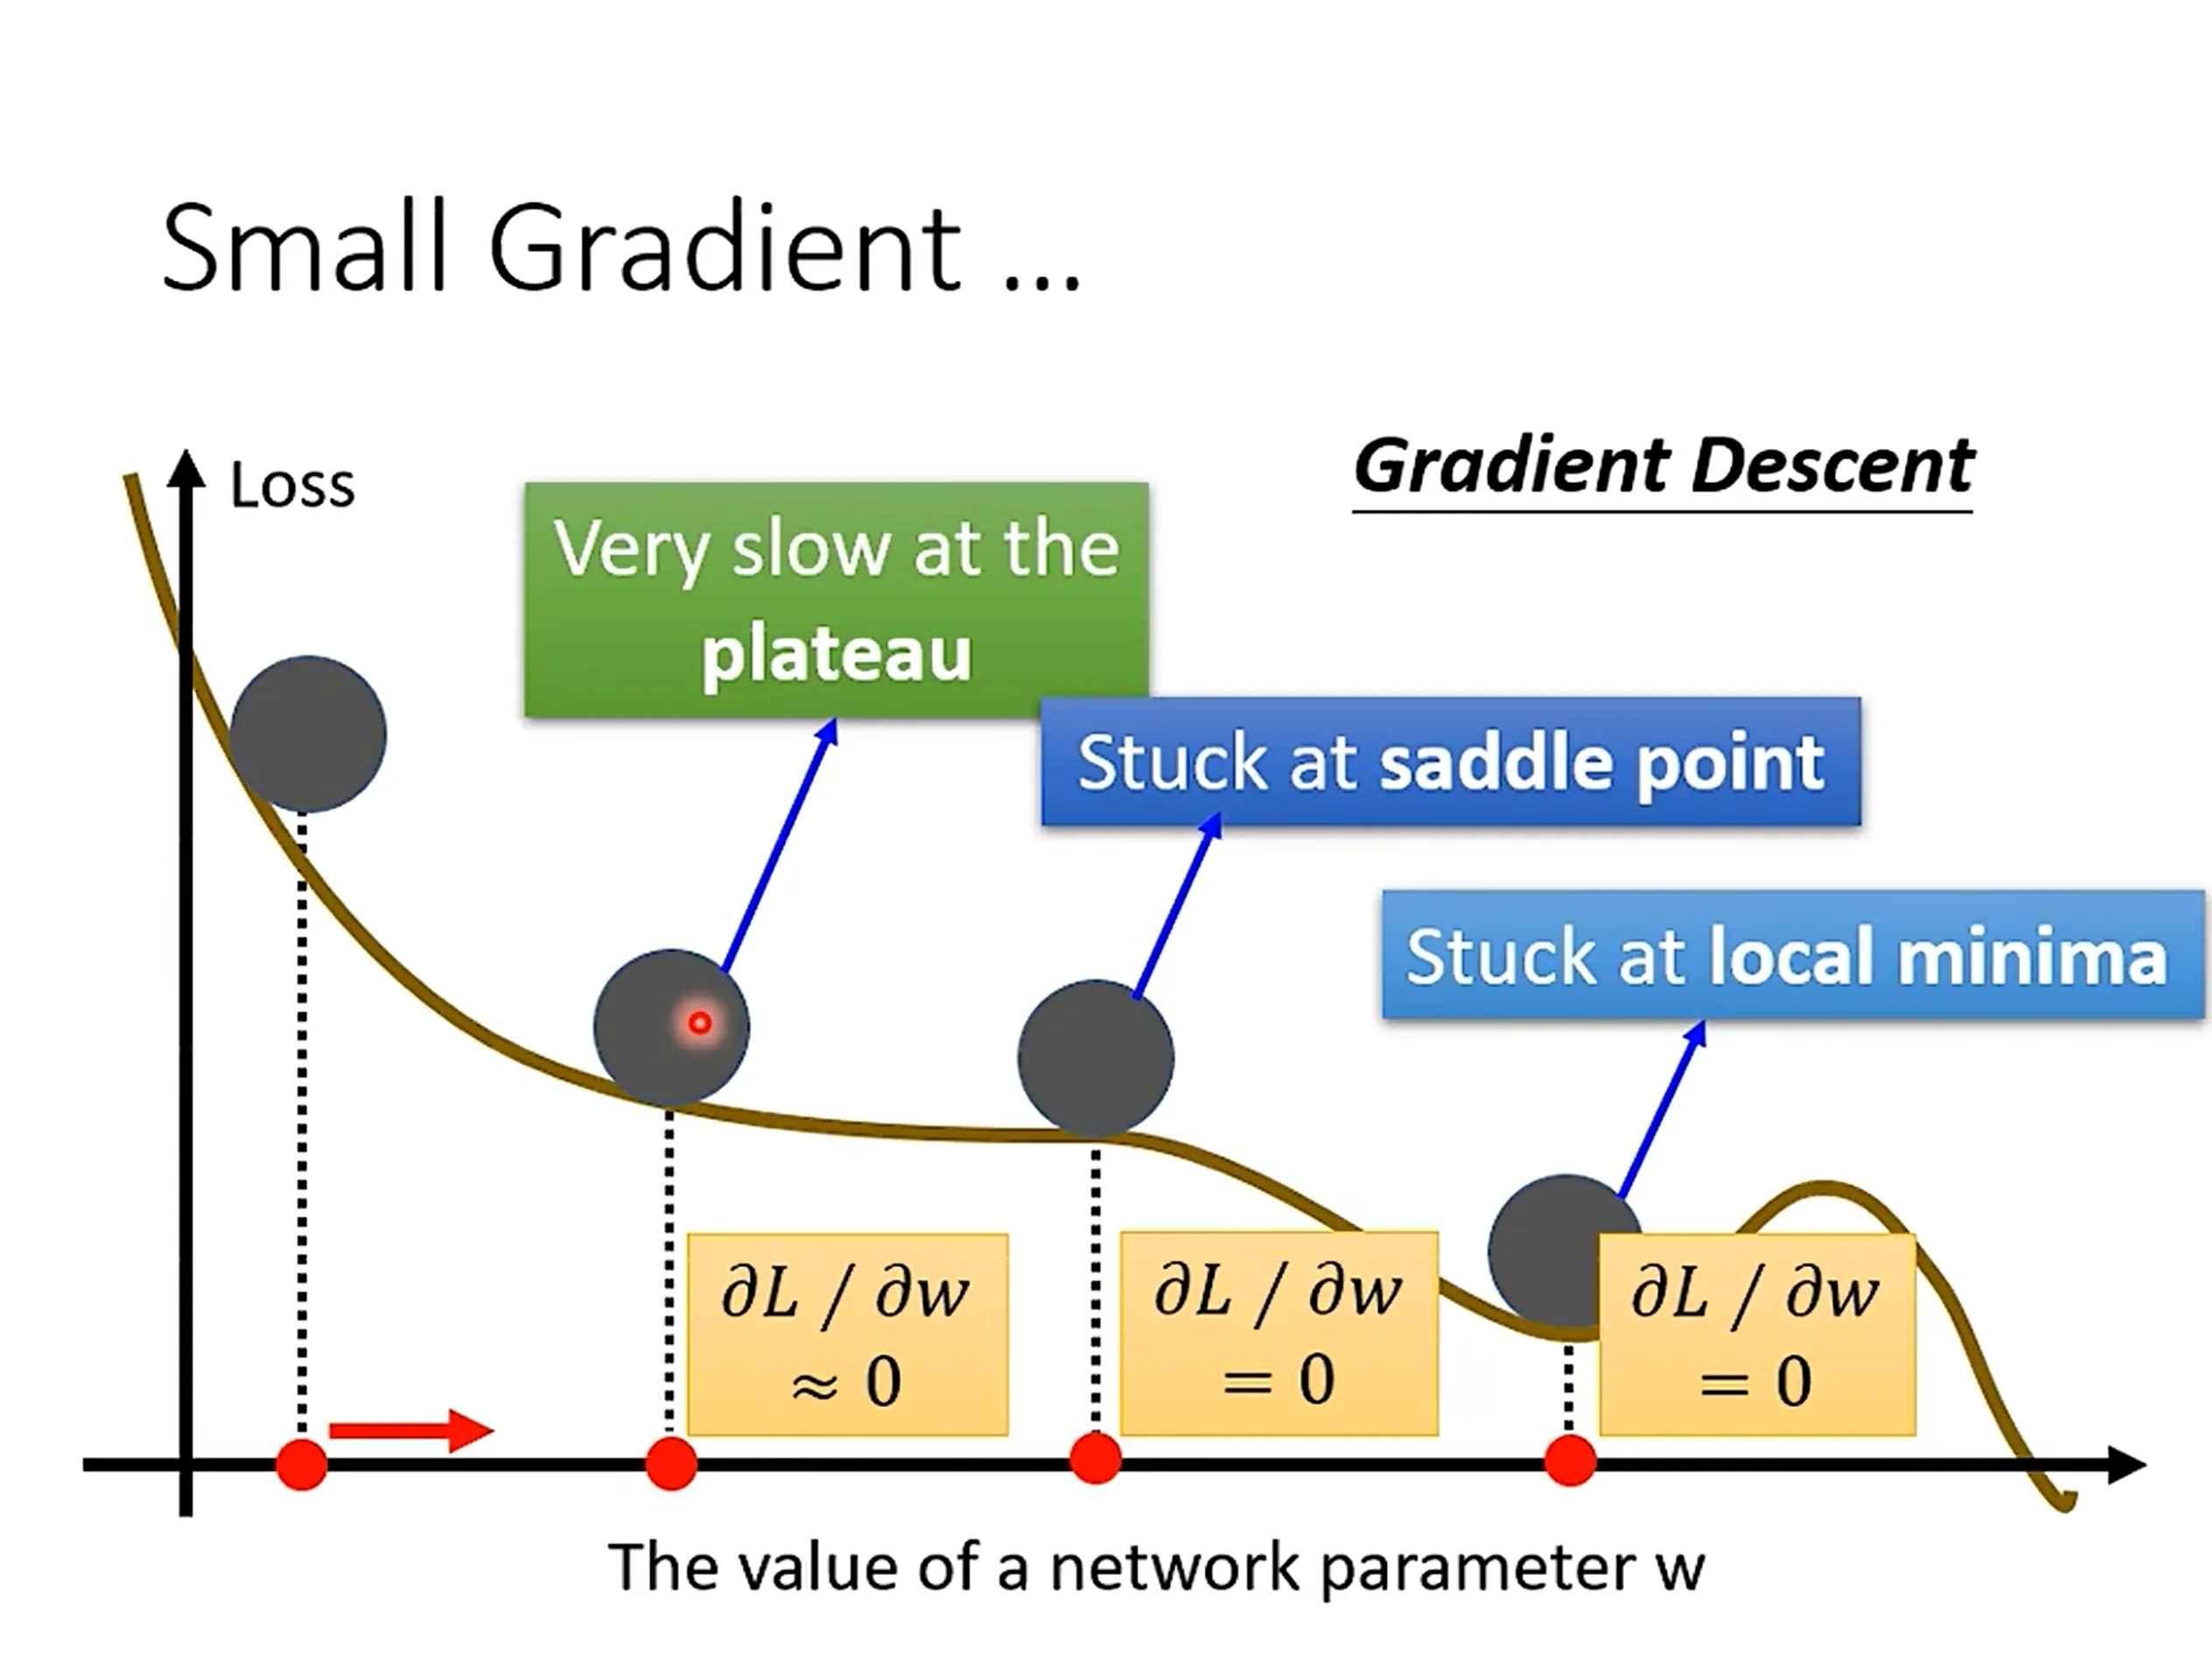
- local minima
- local maxima
- saddle point
- critical point (gradient = 0)
Gradient
梯度消失
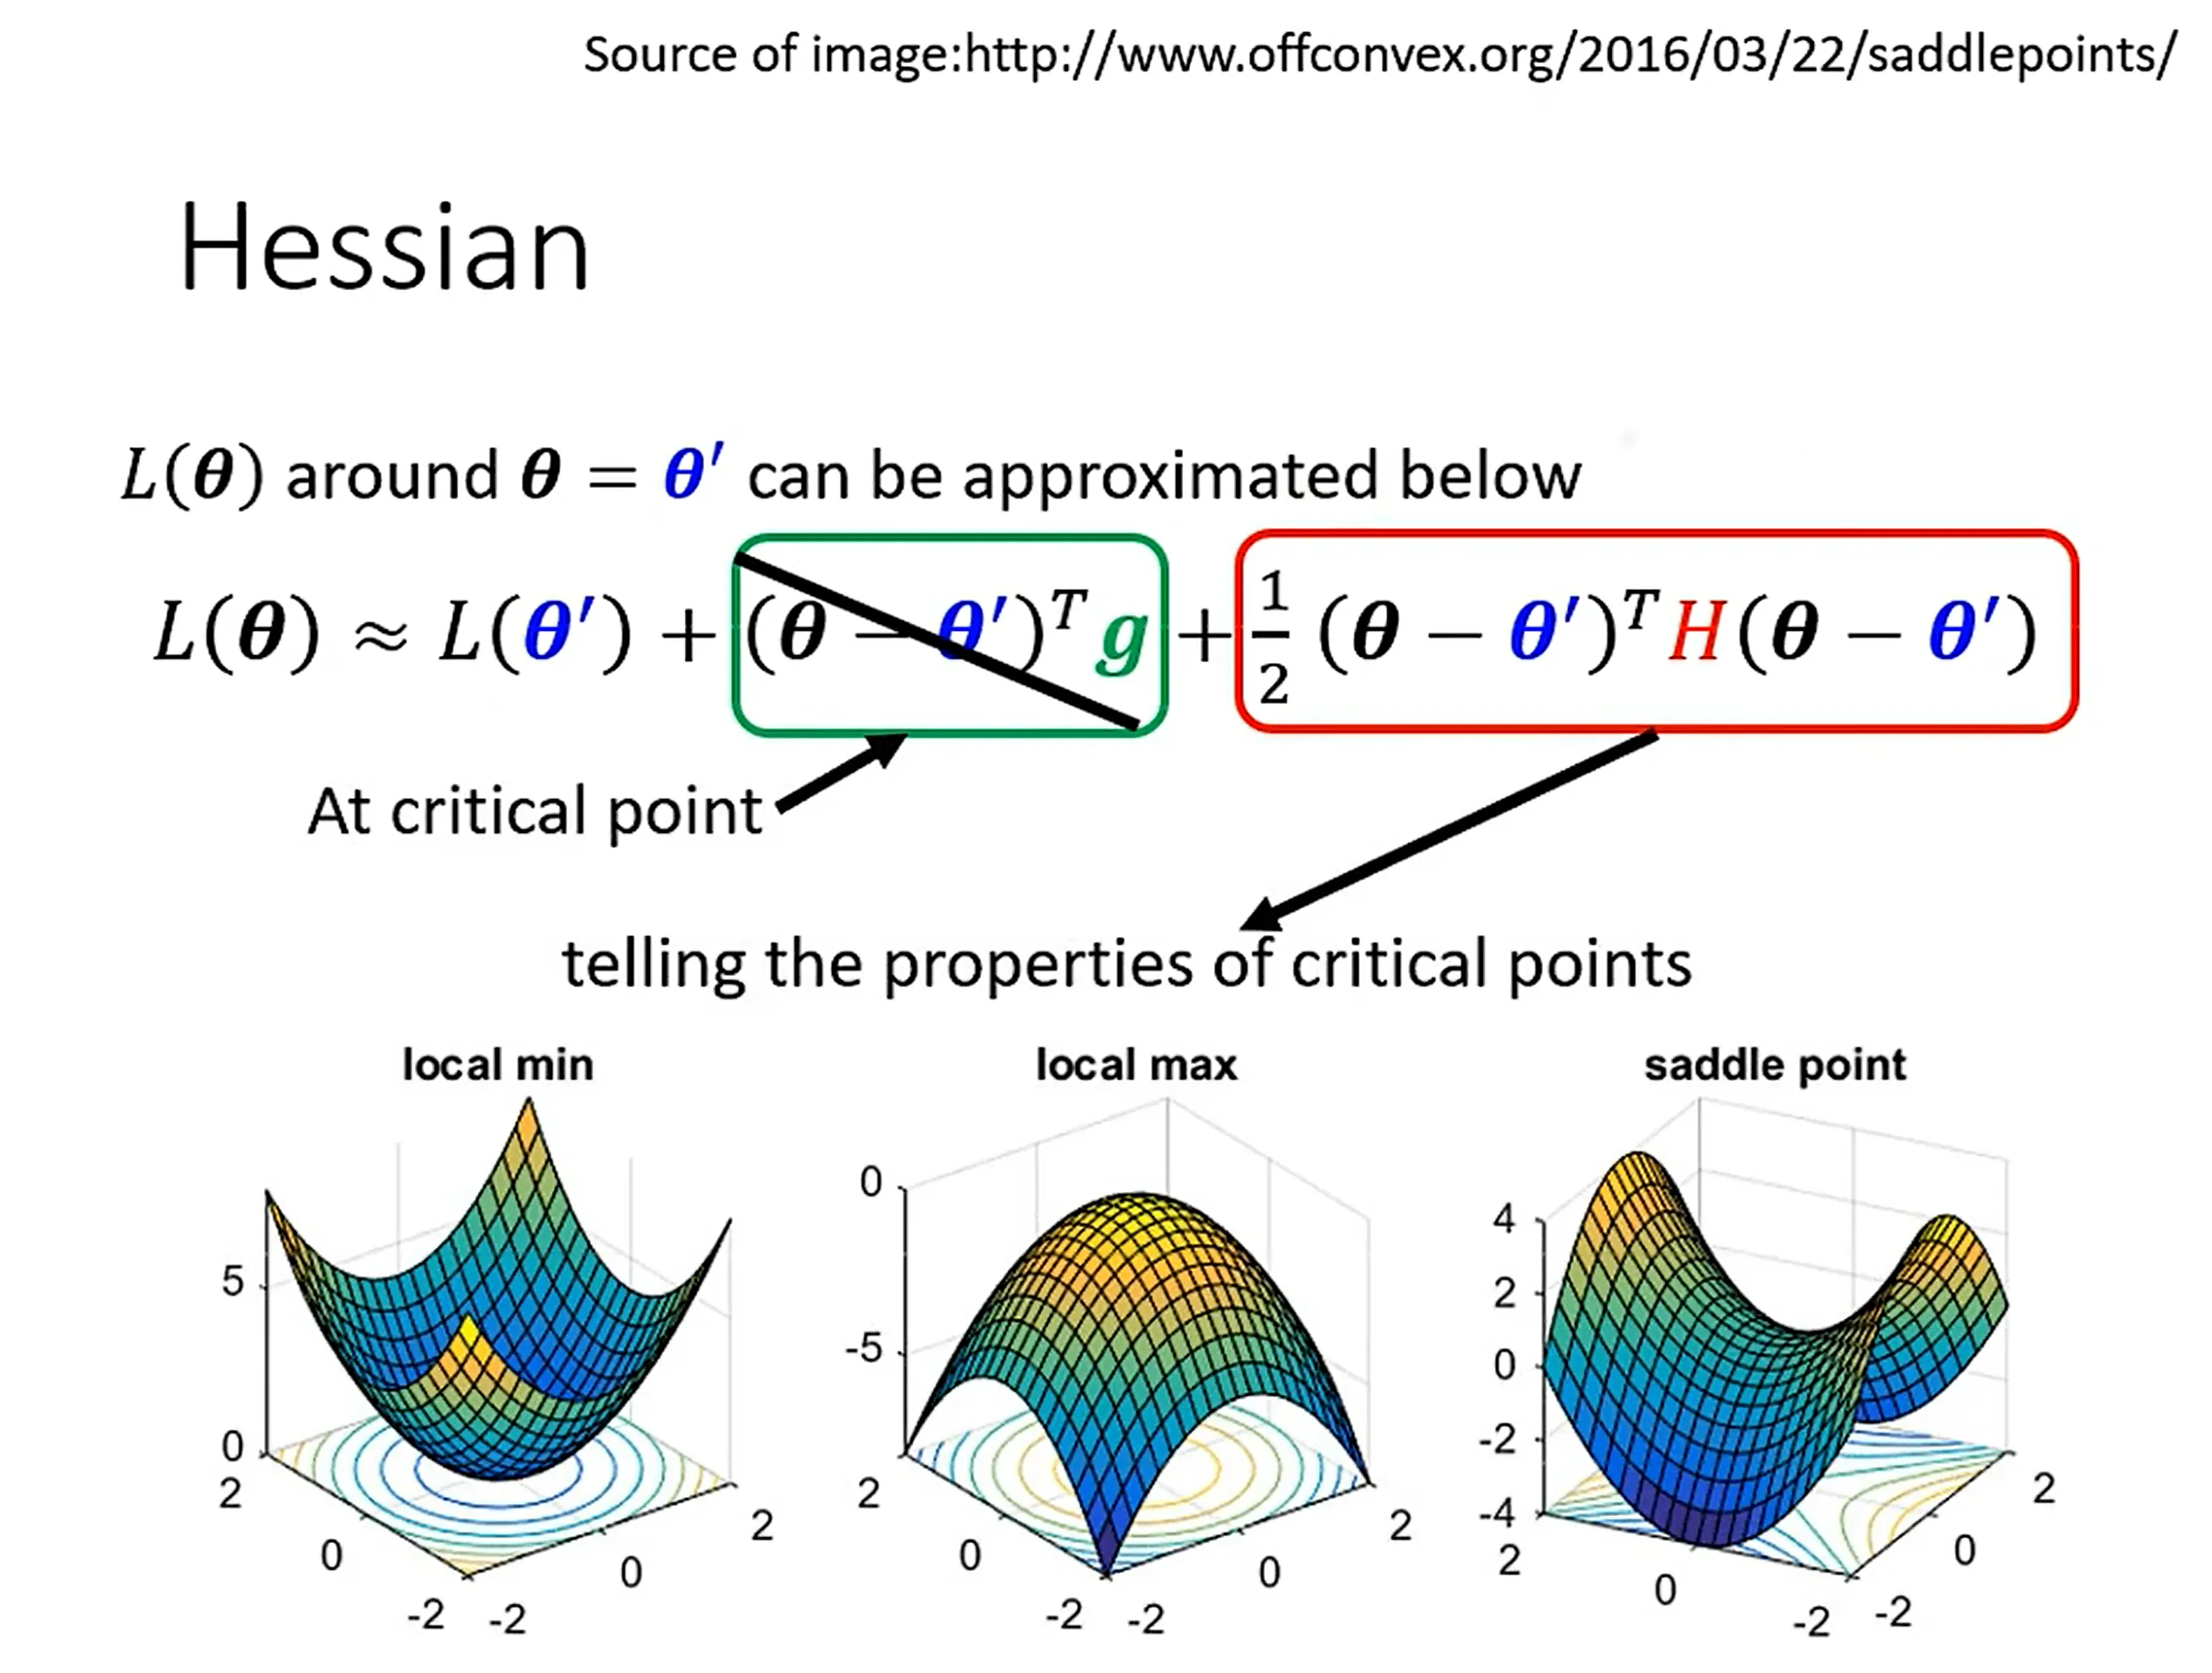
Hessian
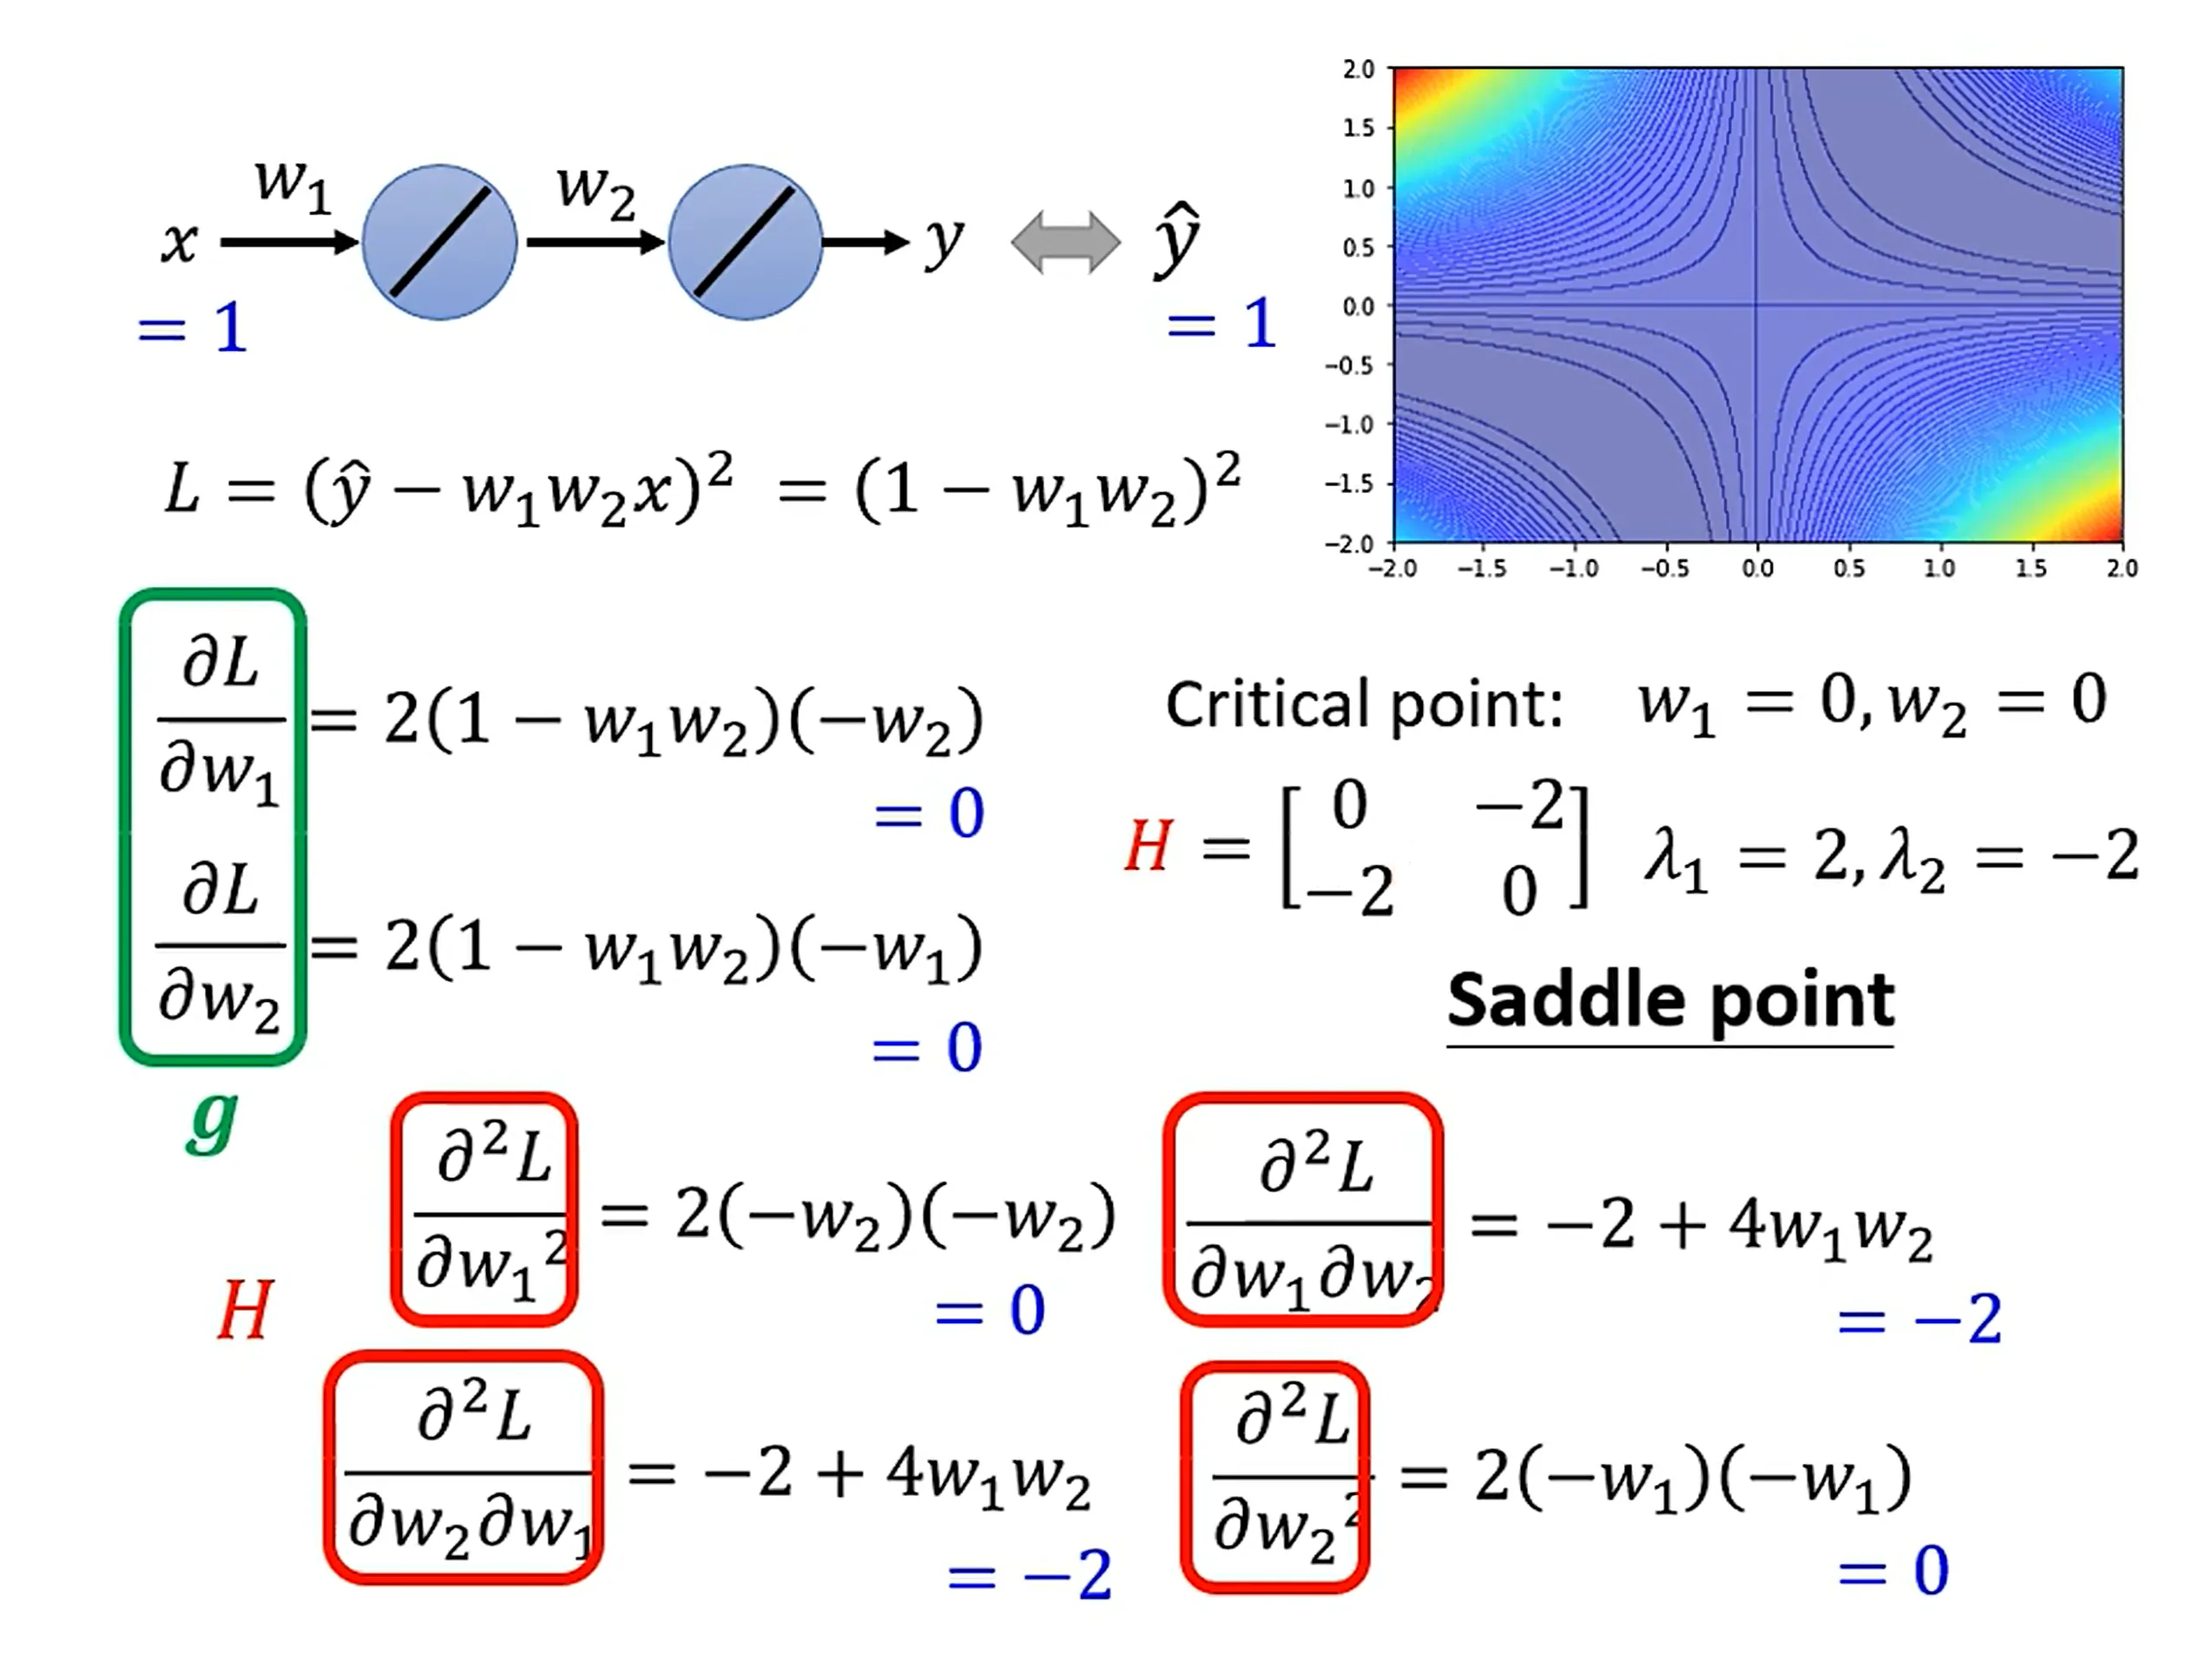
在 saddle point 中可以指出更新方向。也许只存在于低维度,高维度就可以解决。
Batch Size
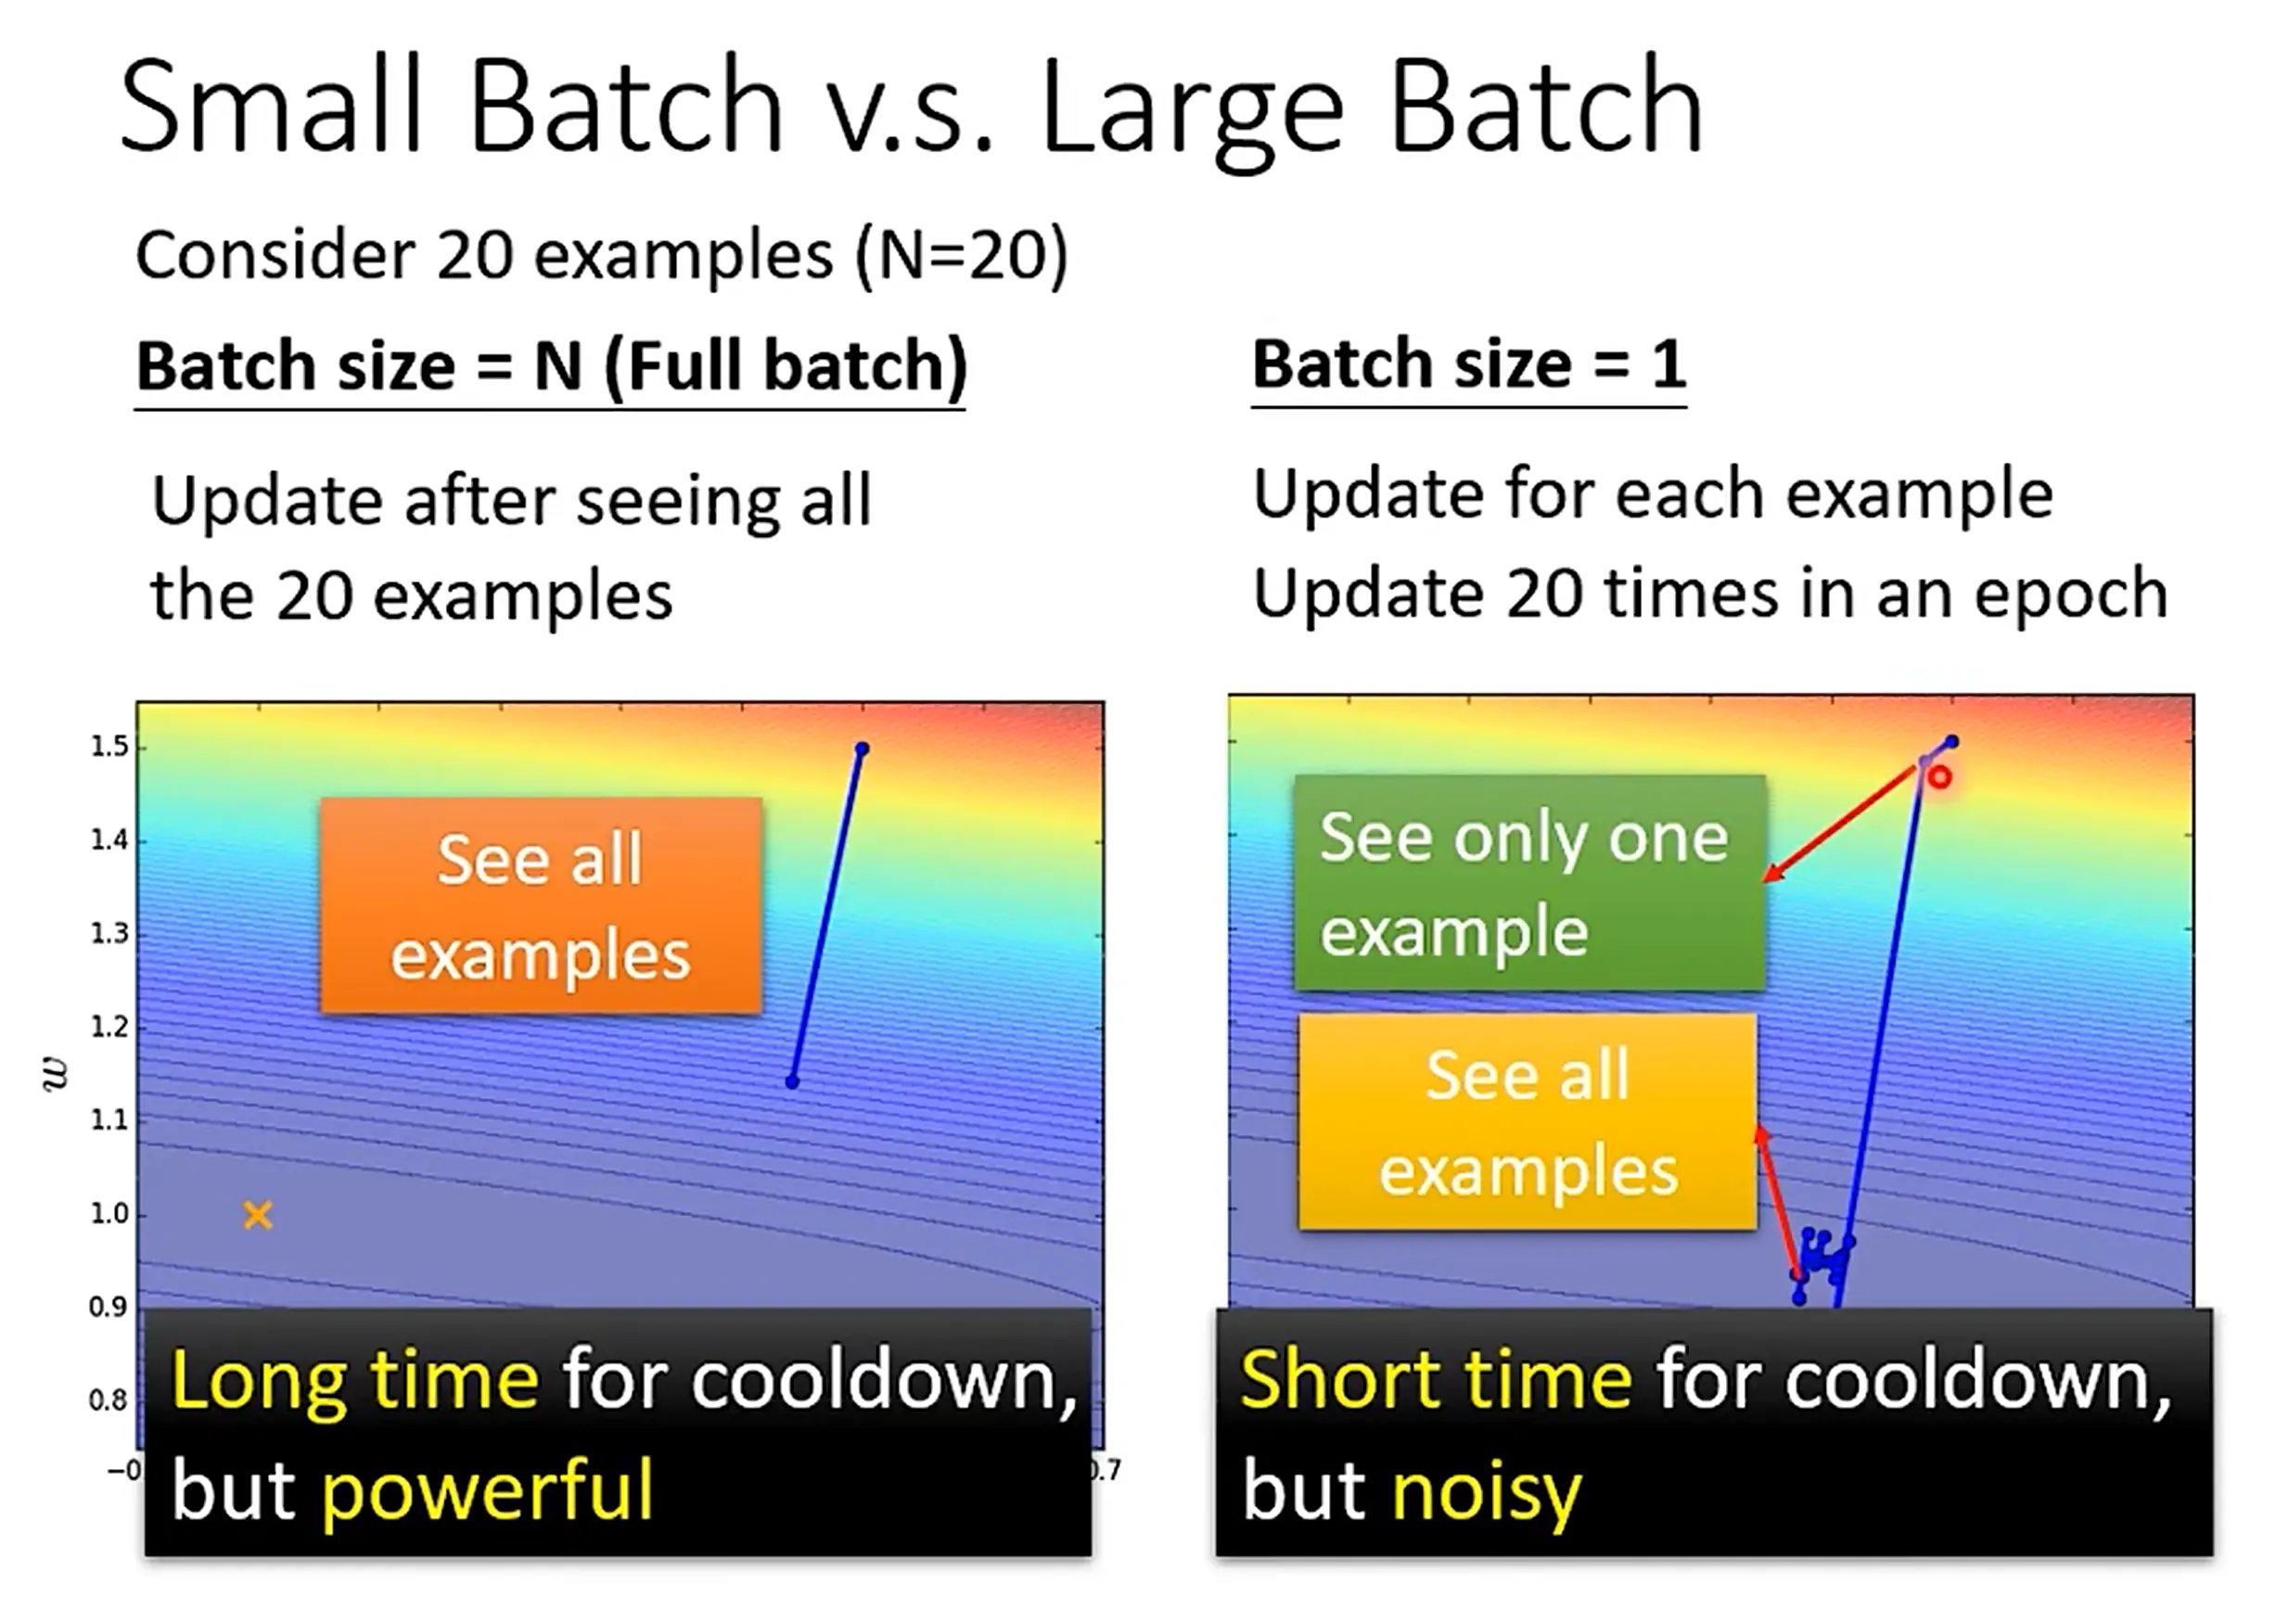
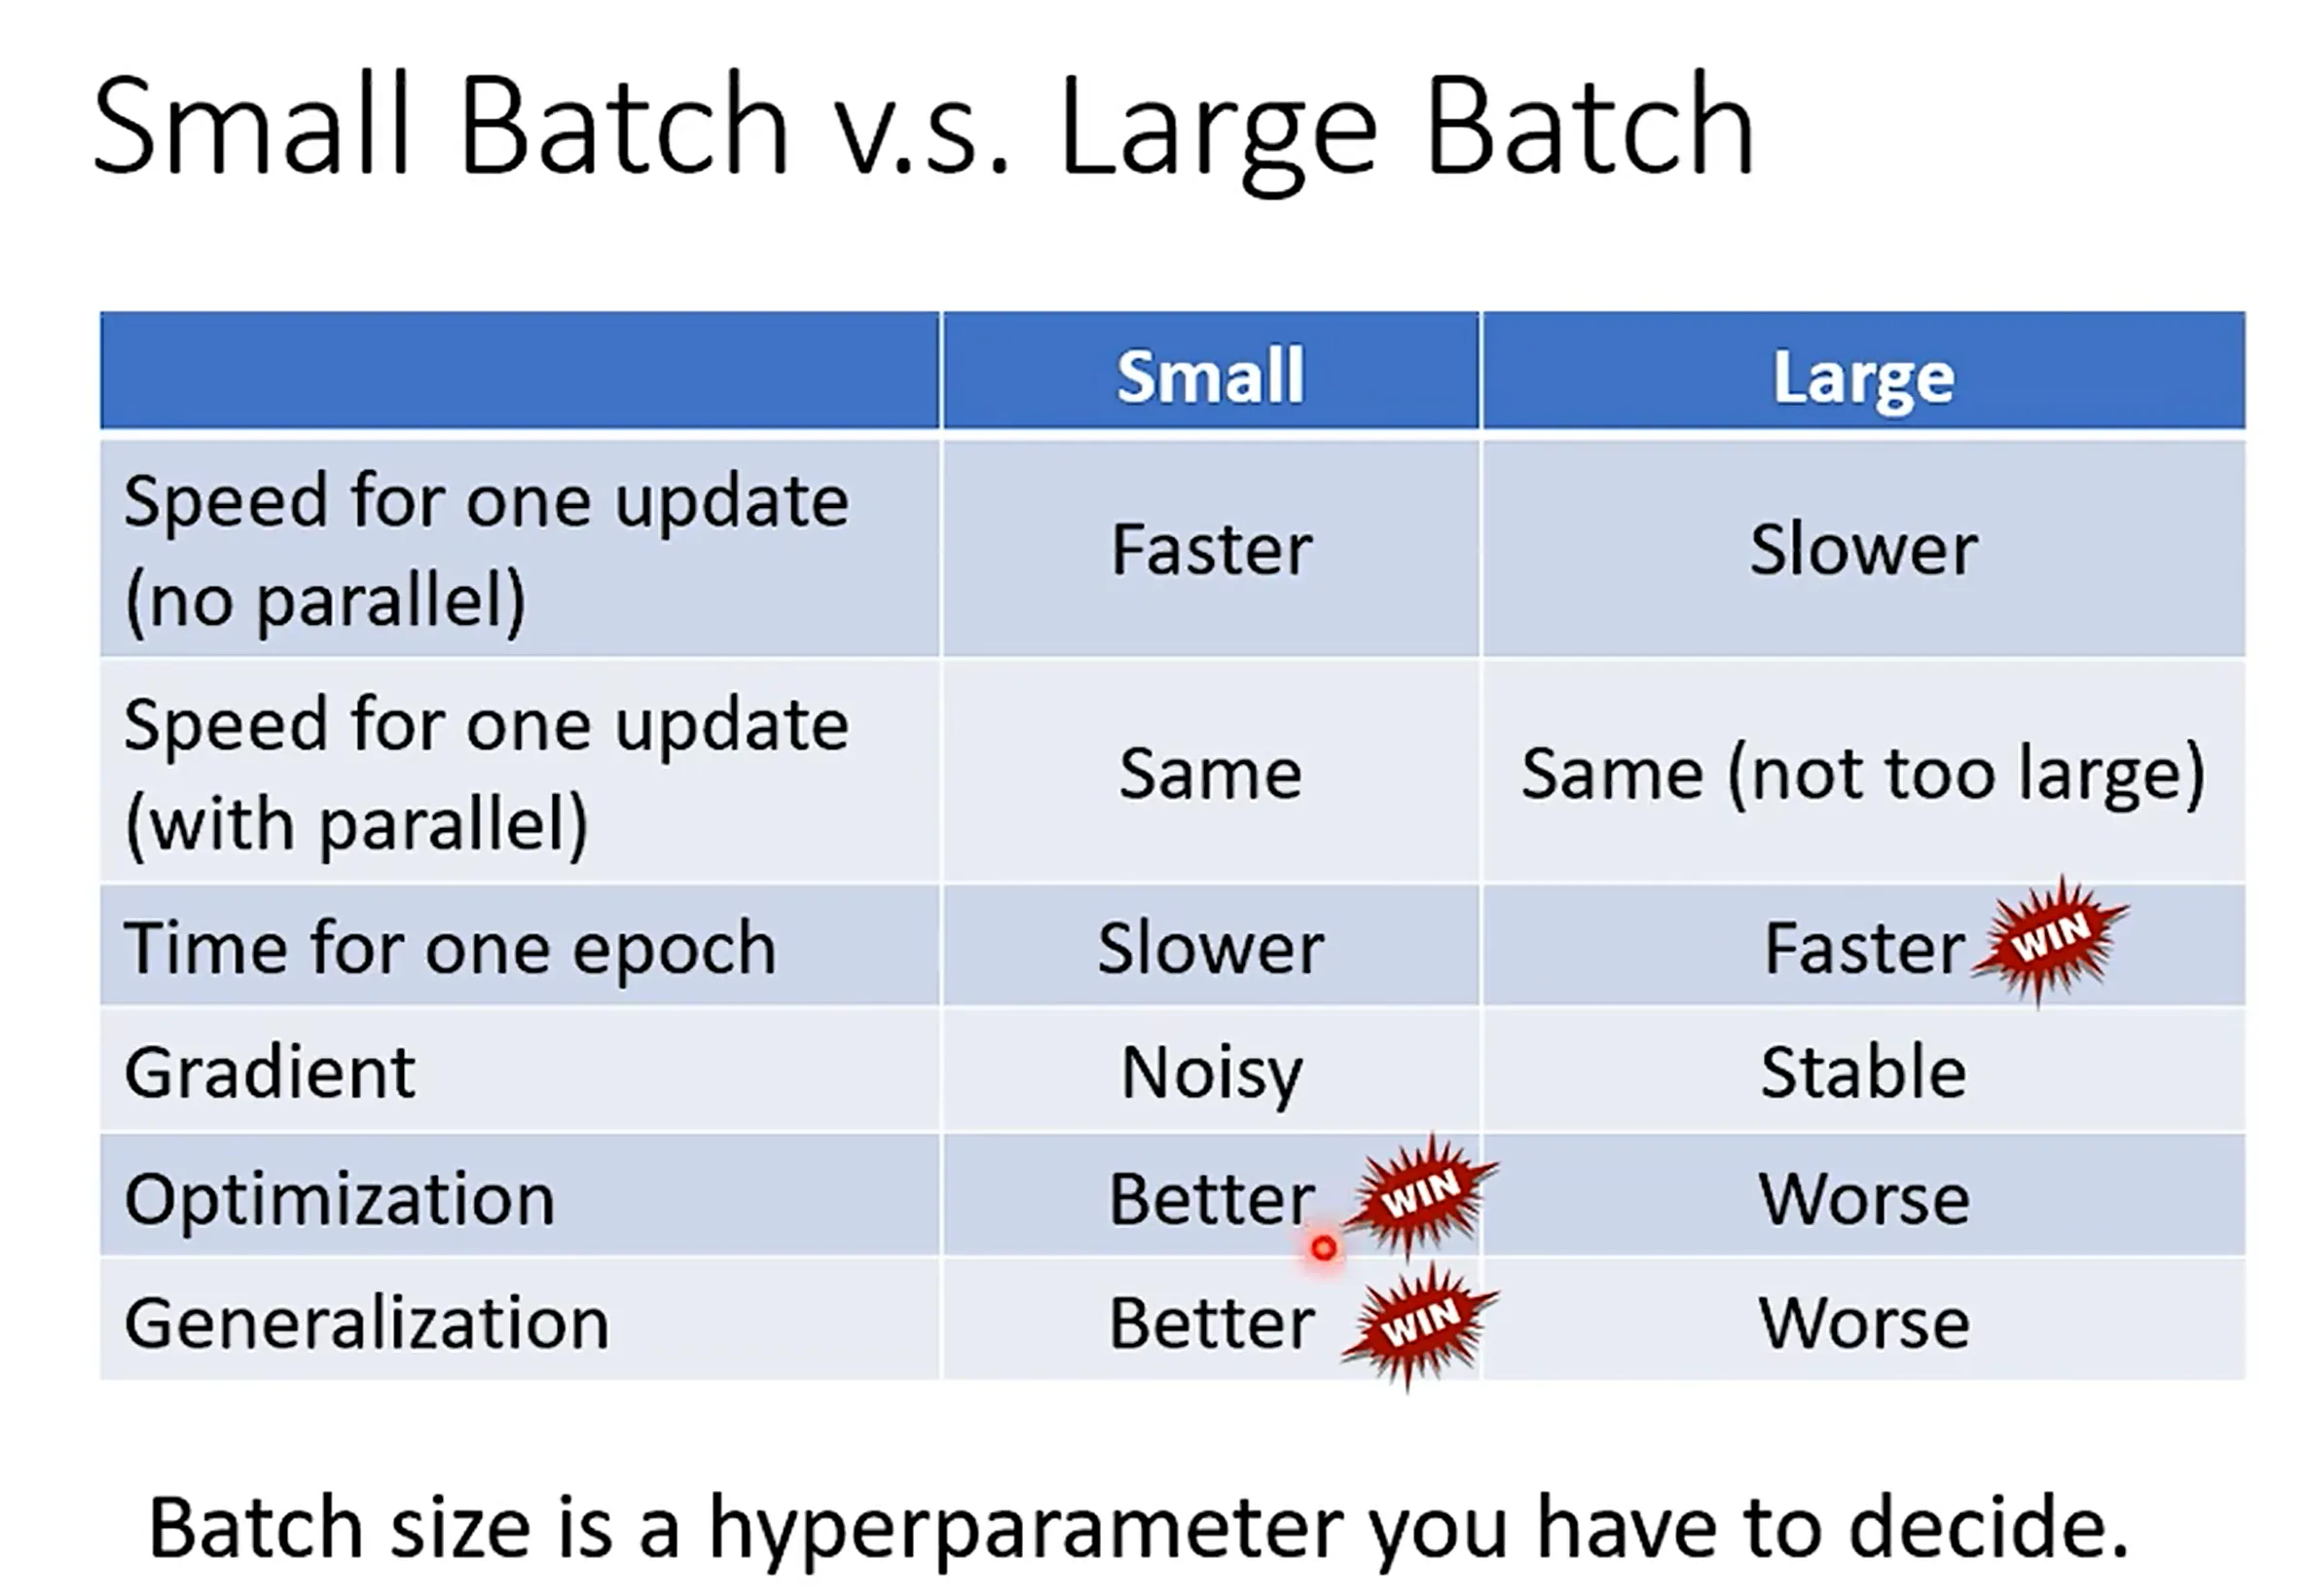
- 小批次更新频率高,每次更新不够精准,但是次数足够多可以弥补。
- 大批次更新频率低,每次更新精准
- 越大的批次不一定越耗时,因为并行计算。但是超过一定大小耗时仍然会大幅上升。
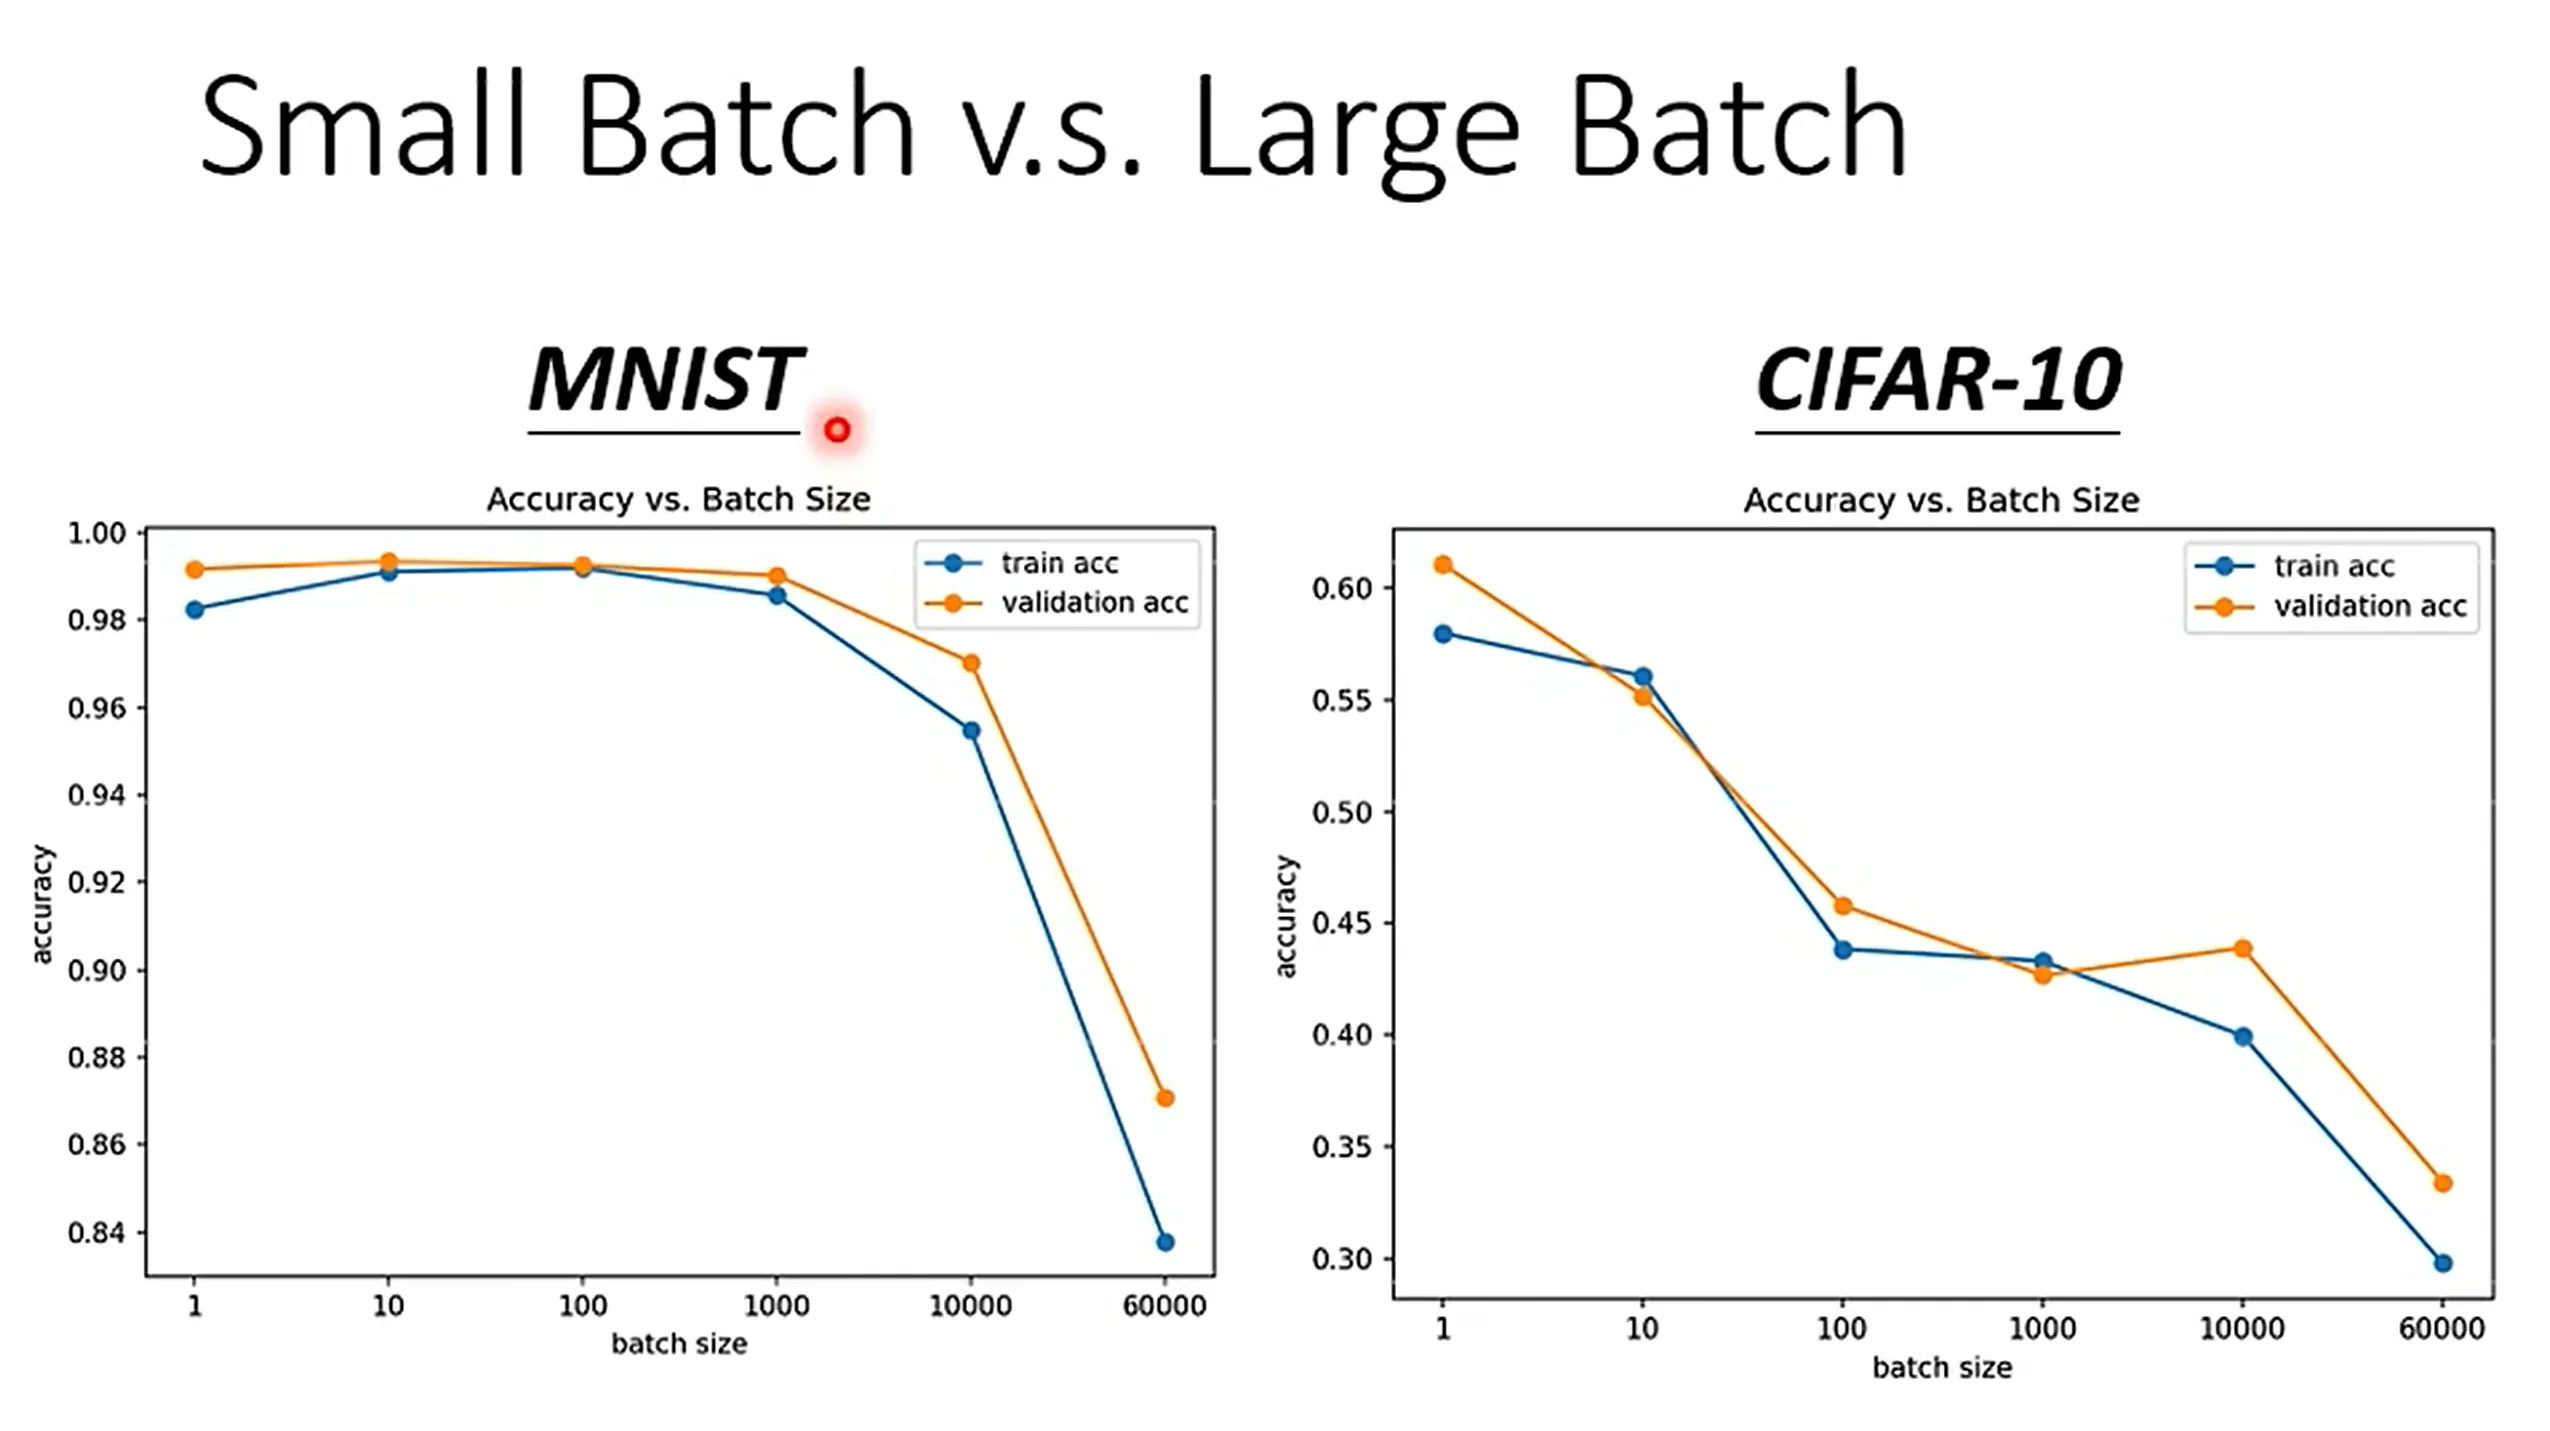
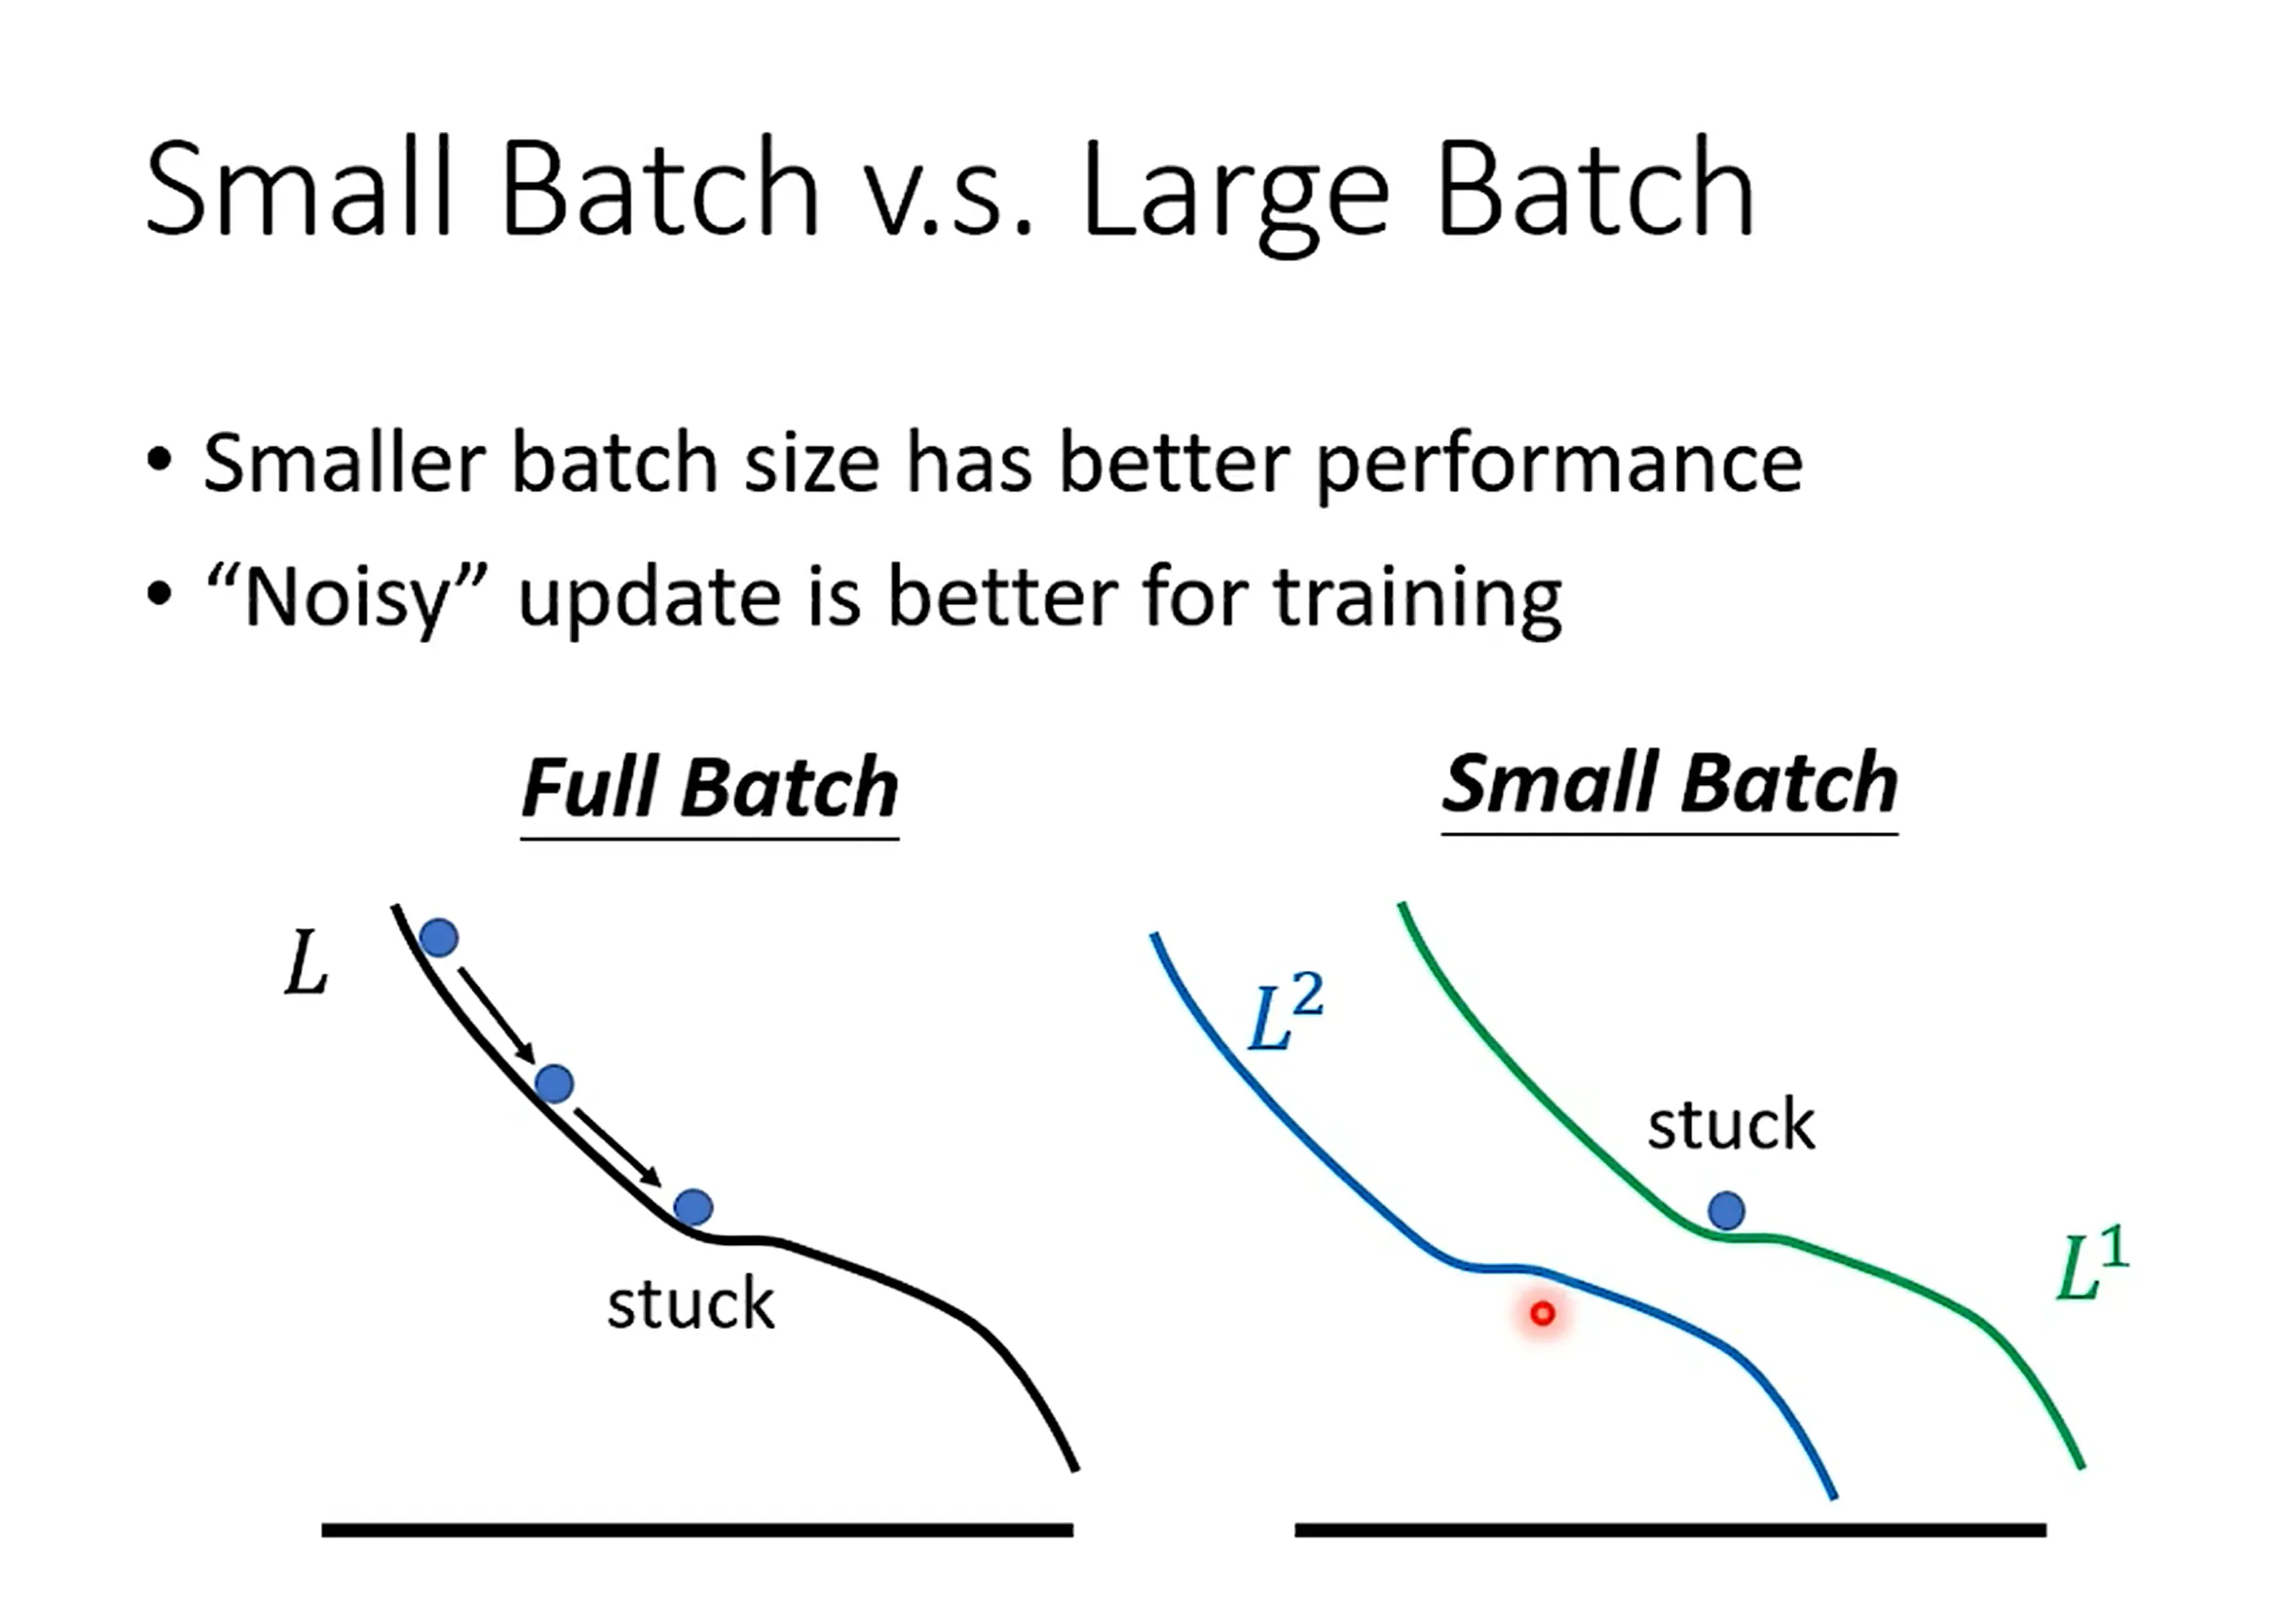
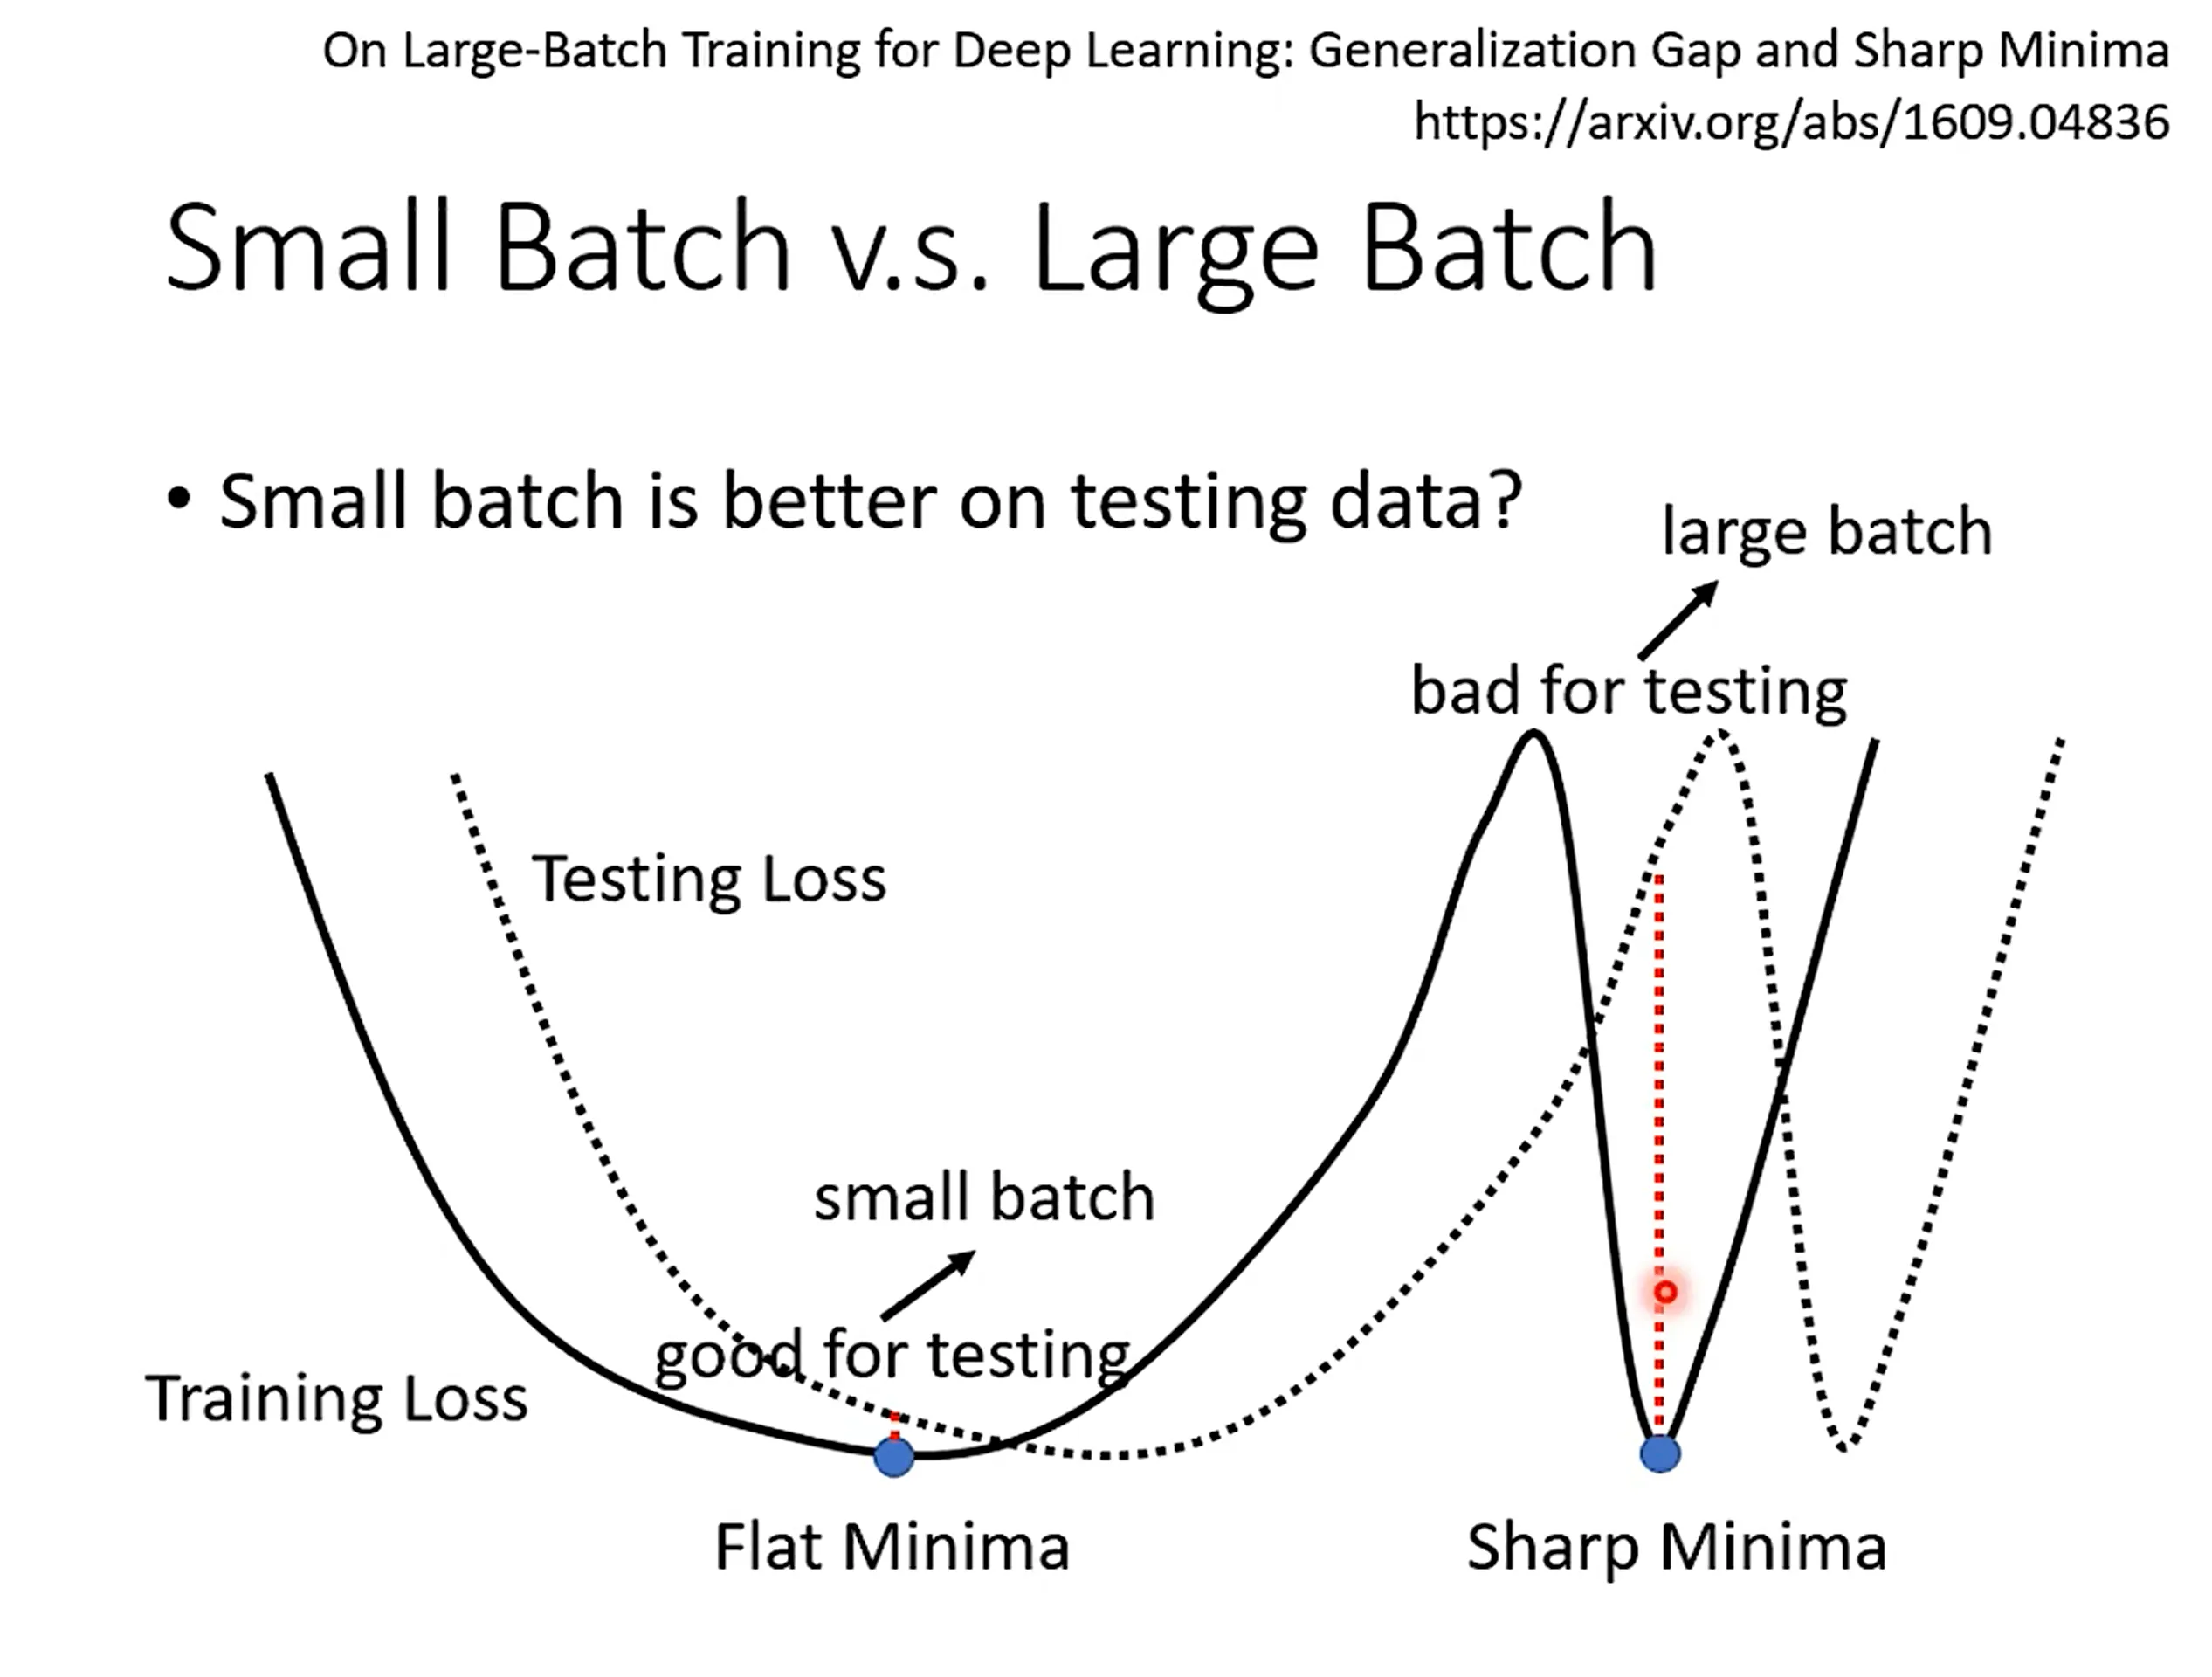
- 大批次变化慢,倾向于落入狭窄范围内的最小点。
- 小批次变化快,不容易约束在狭窄范围内。
Gradient Descent & Momentum
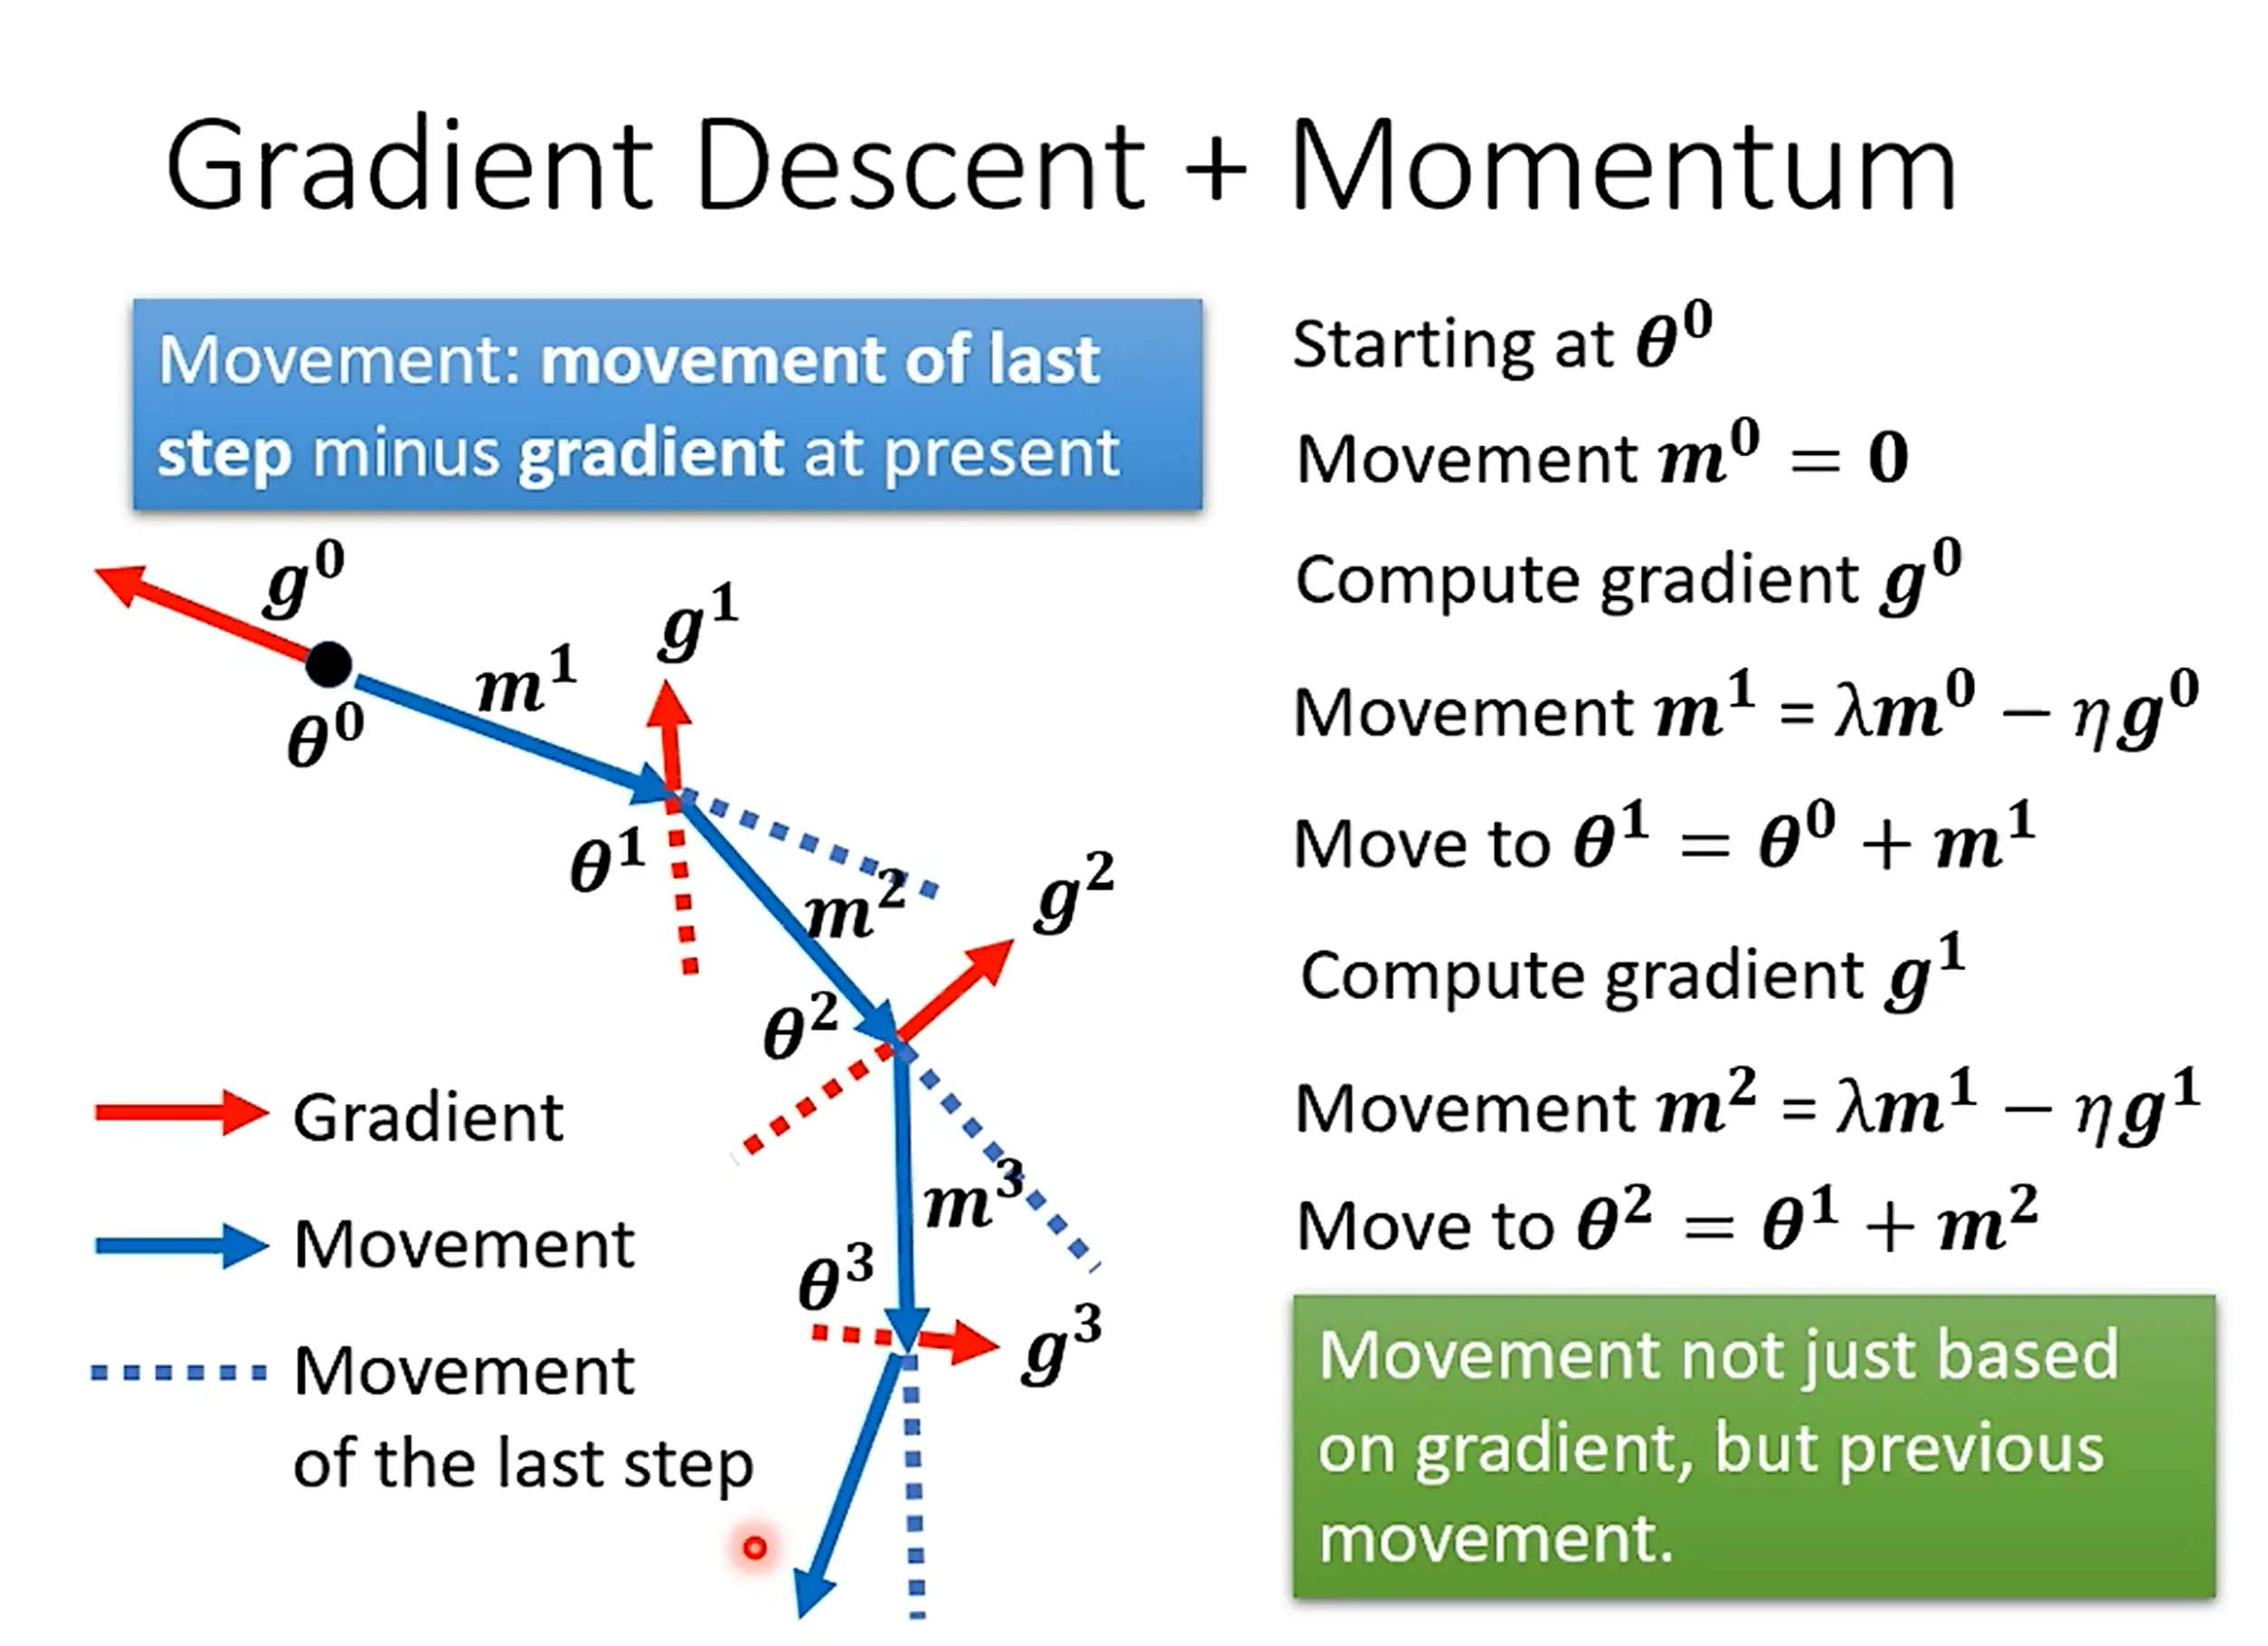
Learning Rate
- loss 不再降低不代表 gradient 很低。
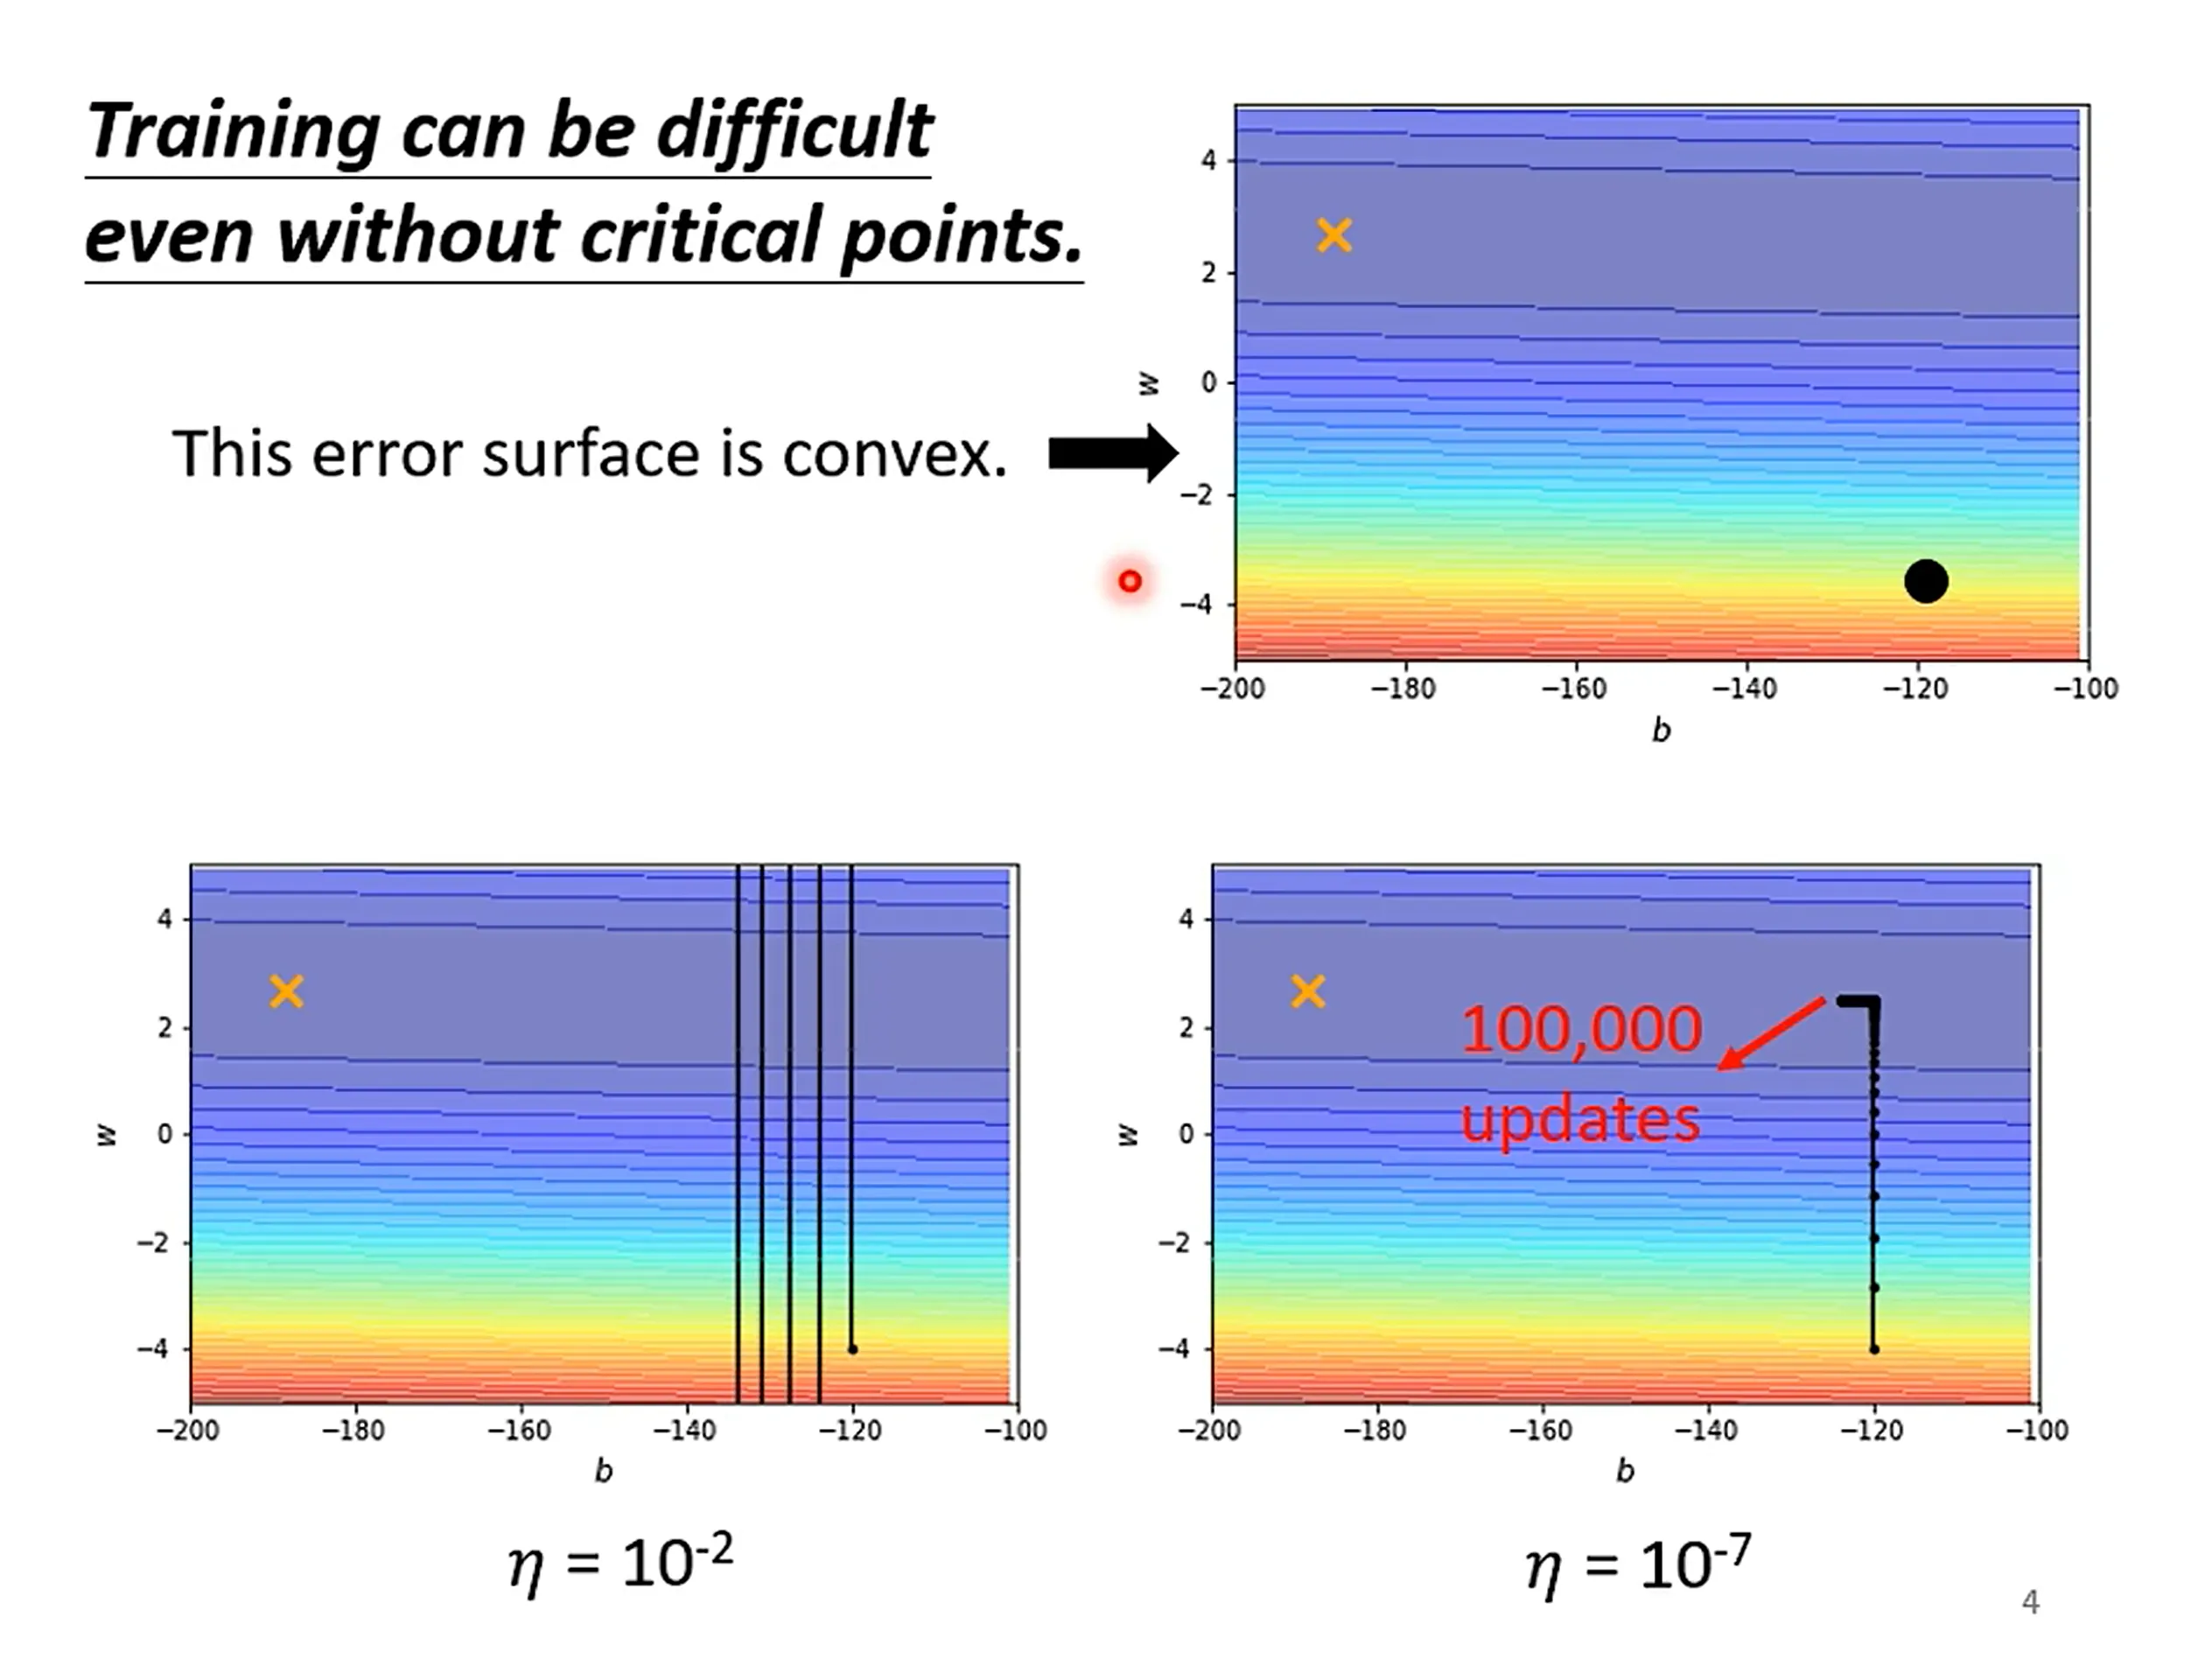
- 学习率太低导致在一个区域内聚集。
RMSProp
动态调整,避免卡在一个小范围内。
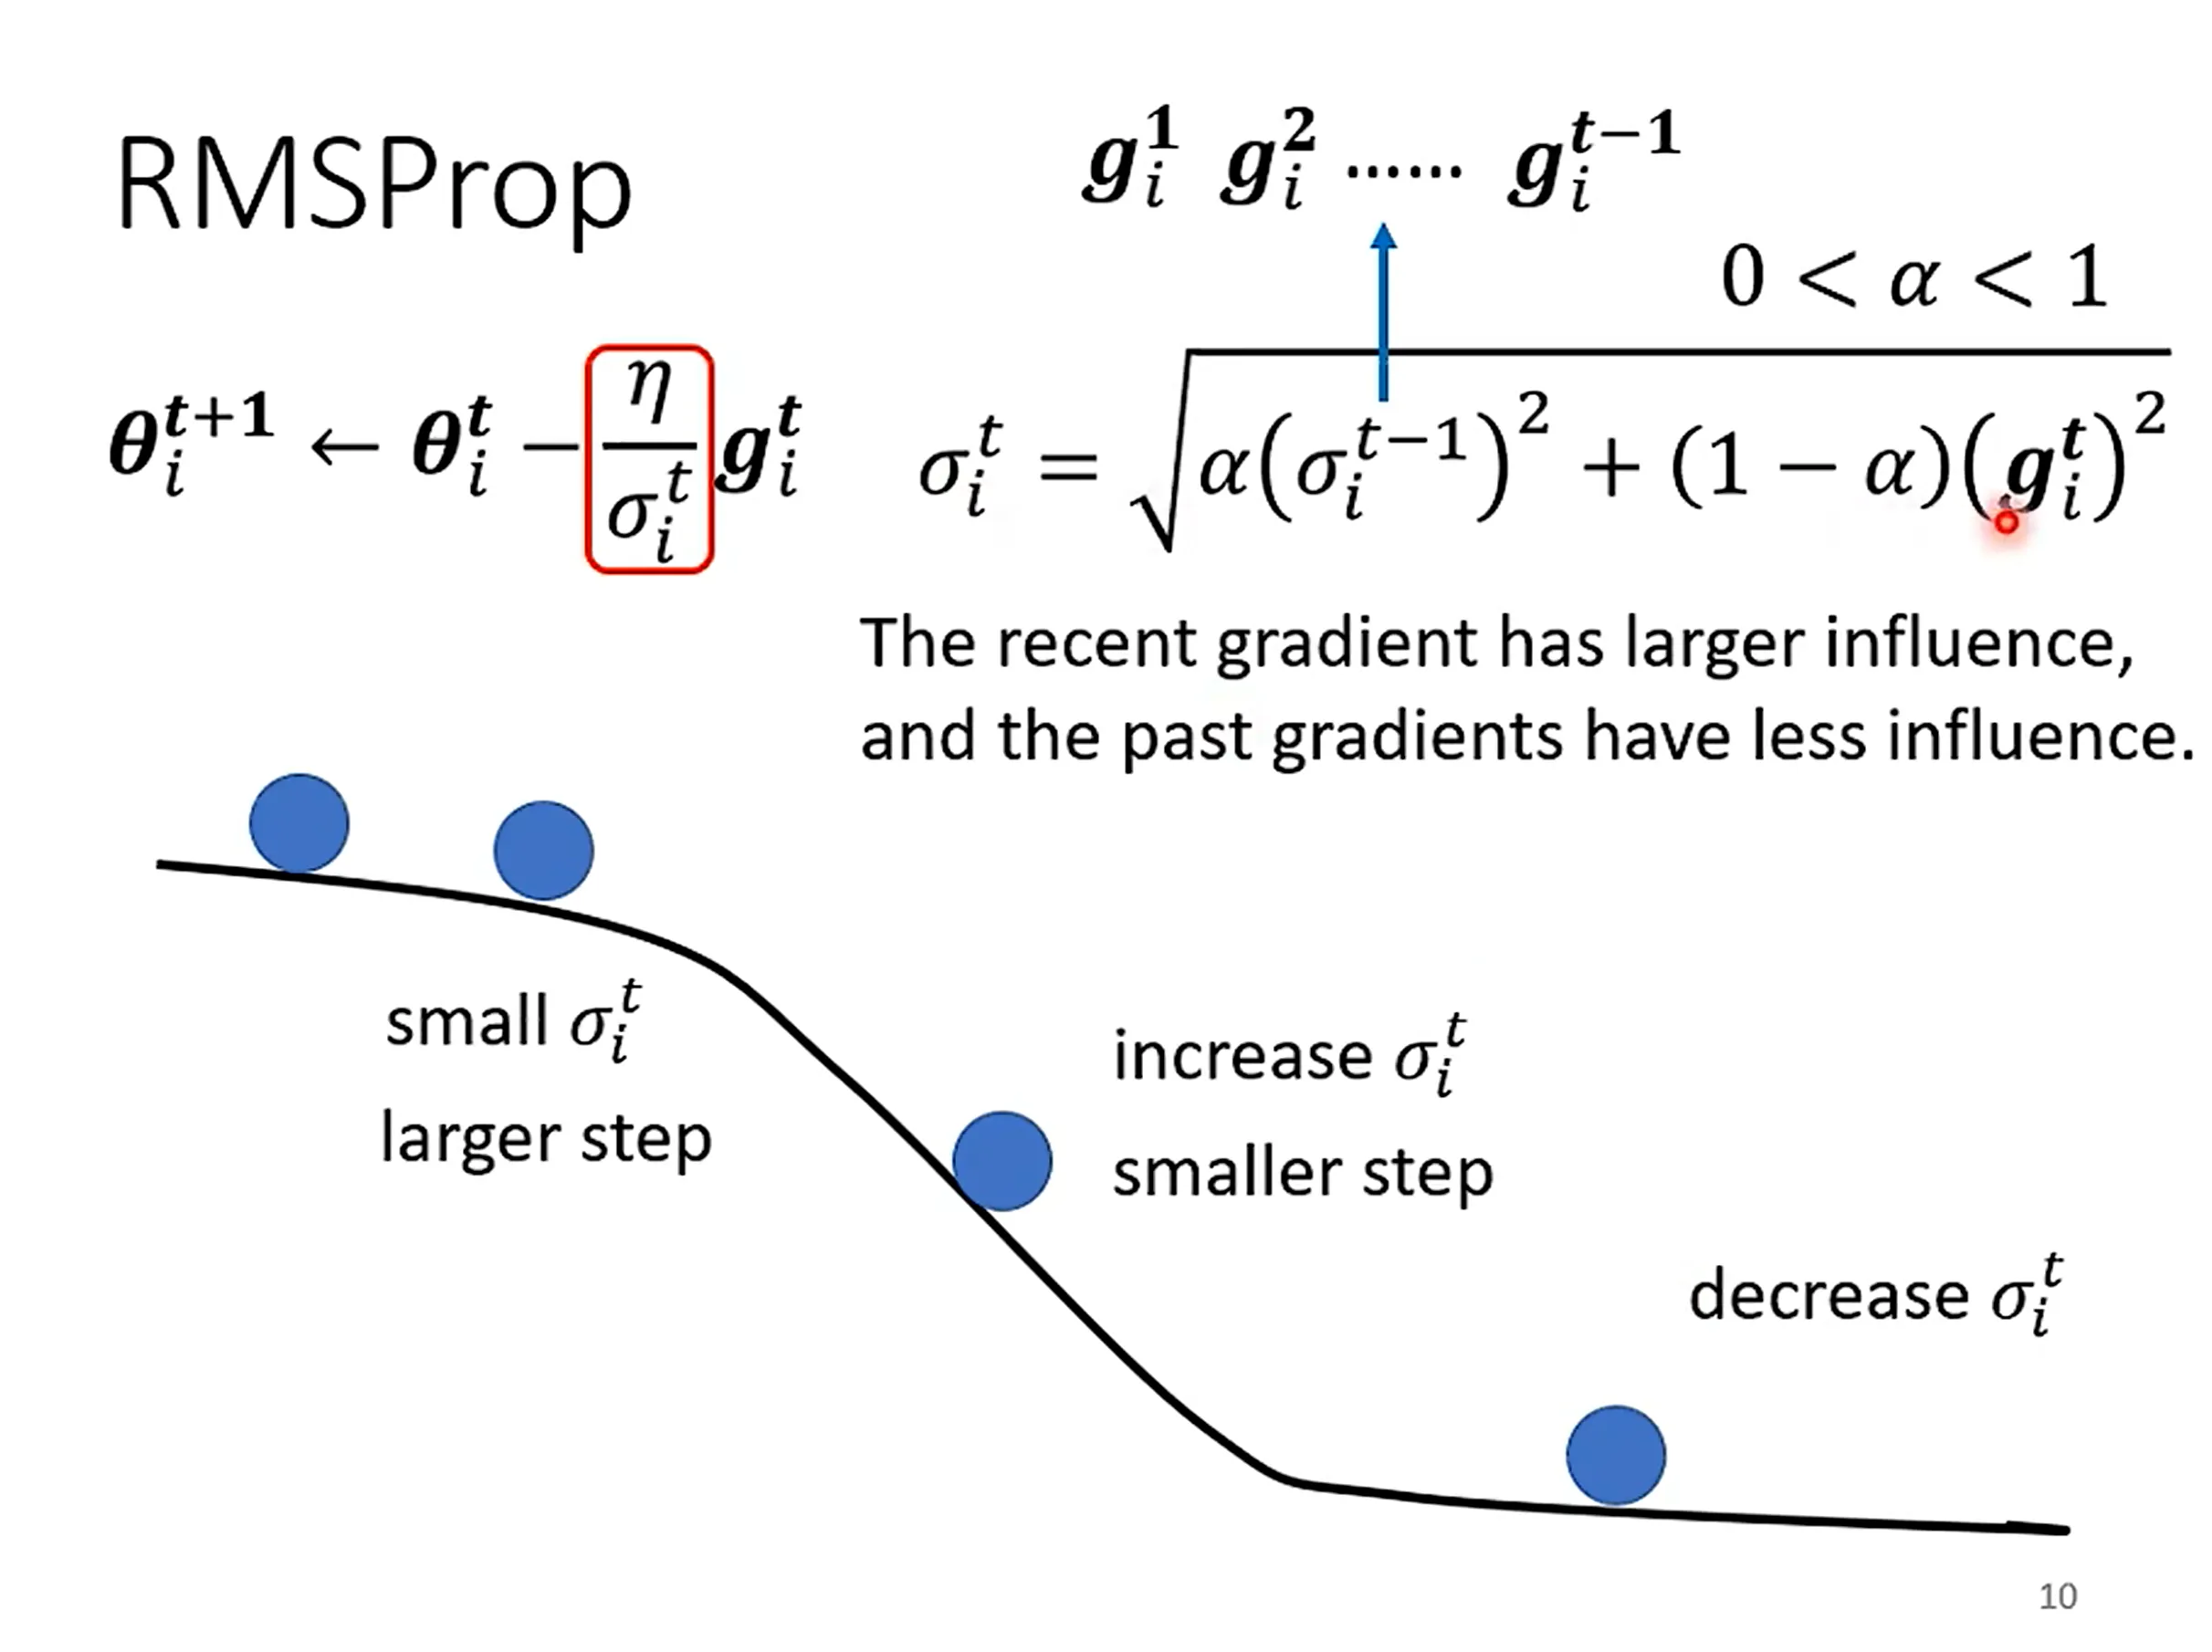
- Adam = RMSProp + Momentum
Softmax
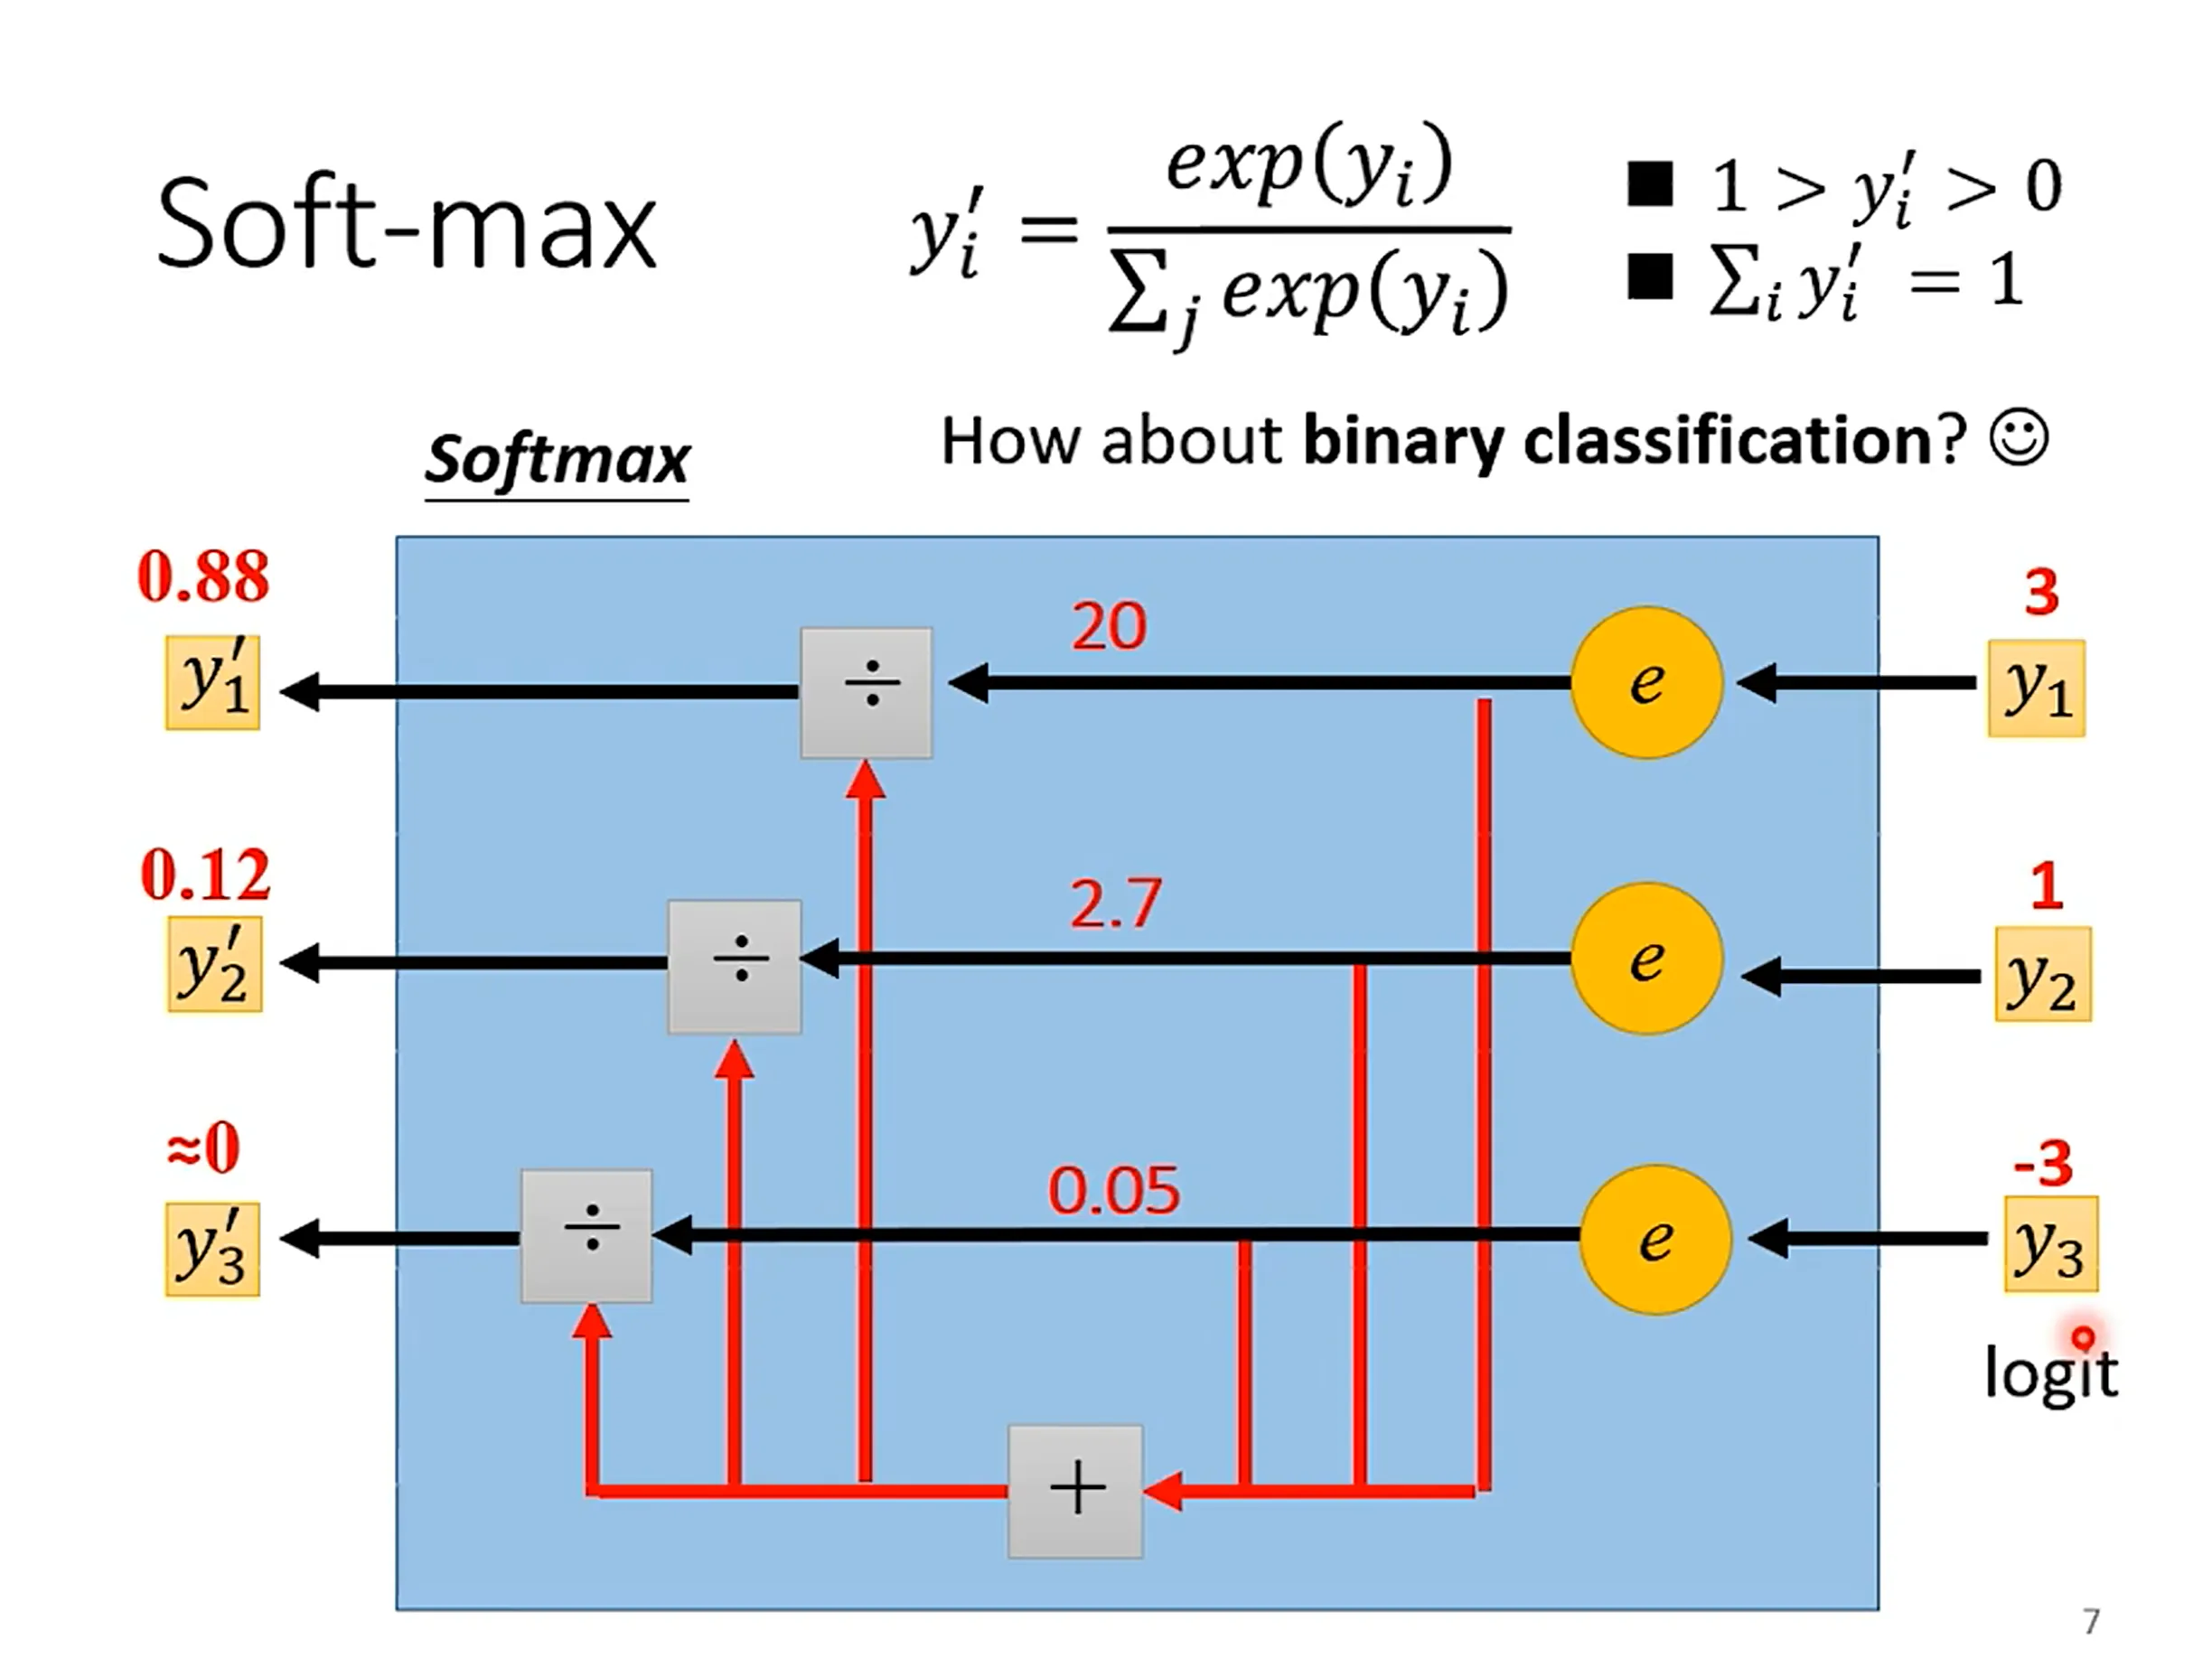
- 差距拉大,并且最大最小都保持在 0-1 之间。
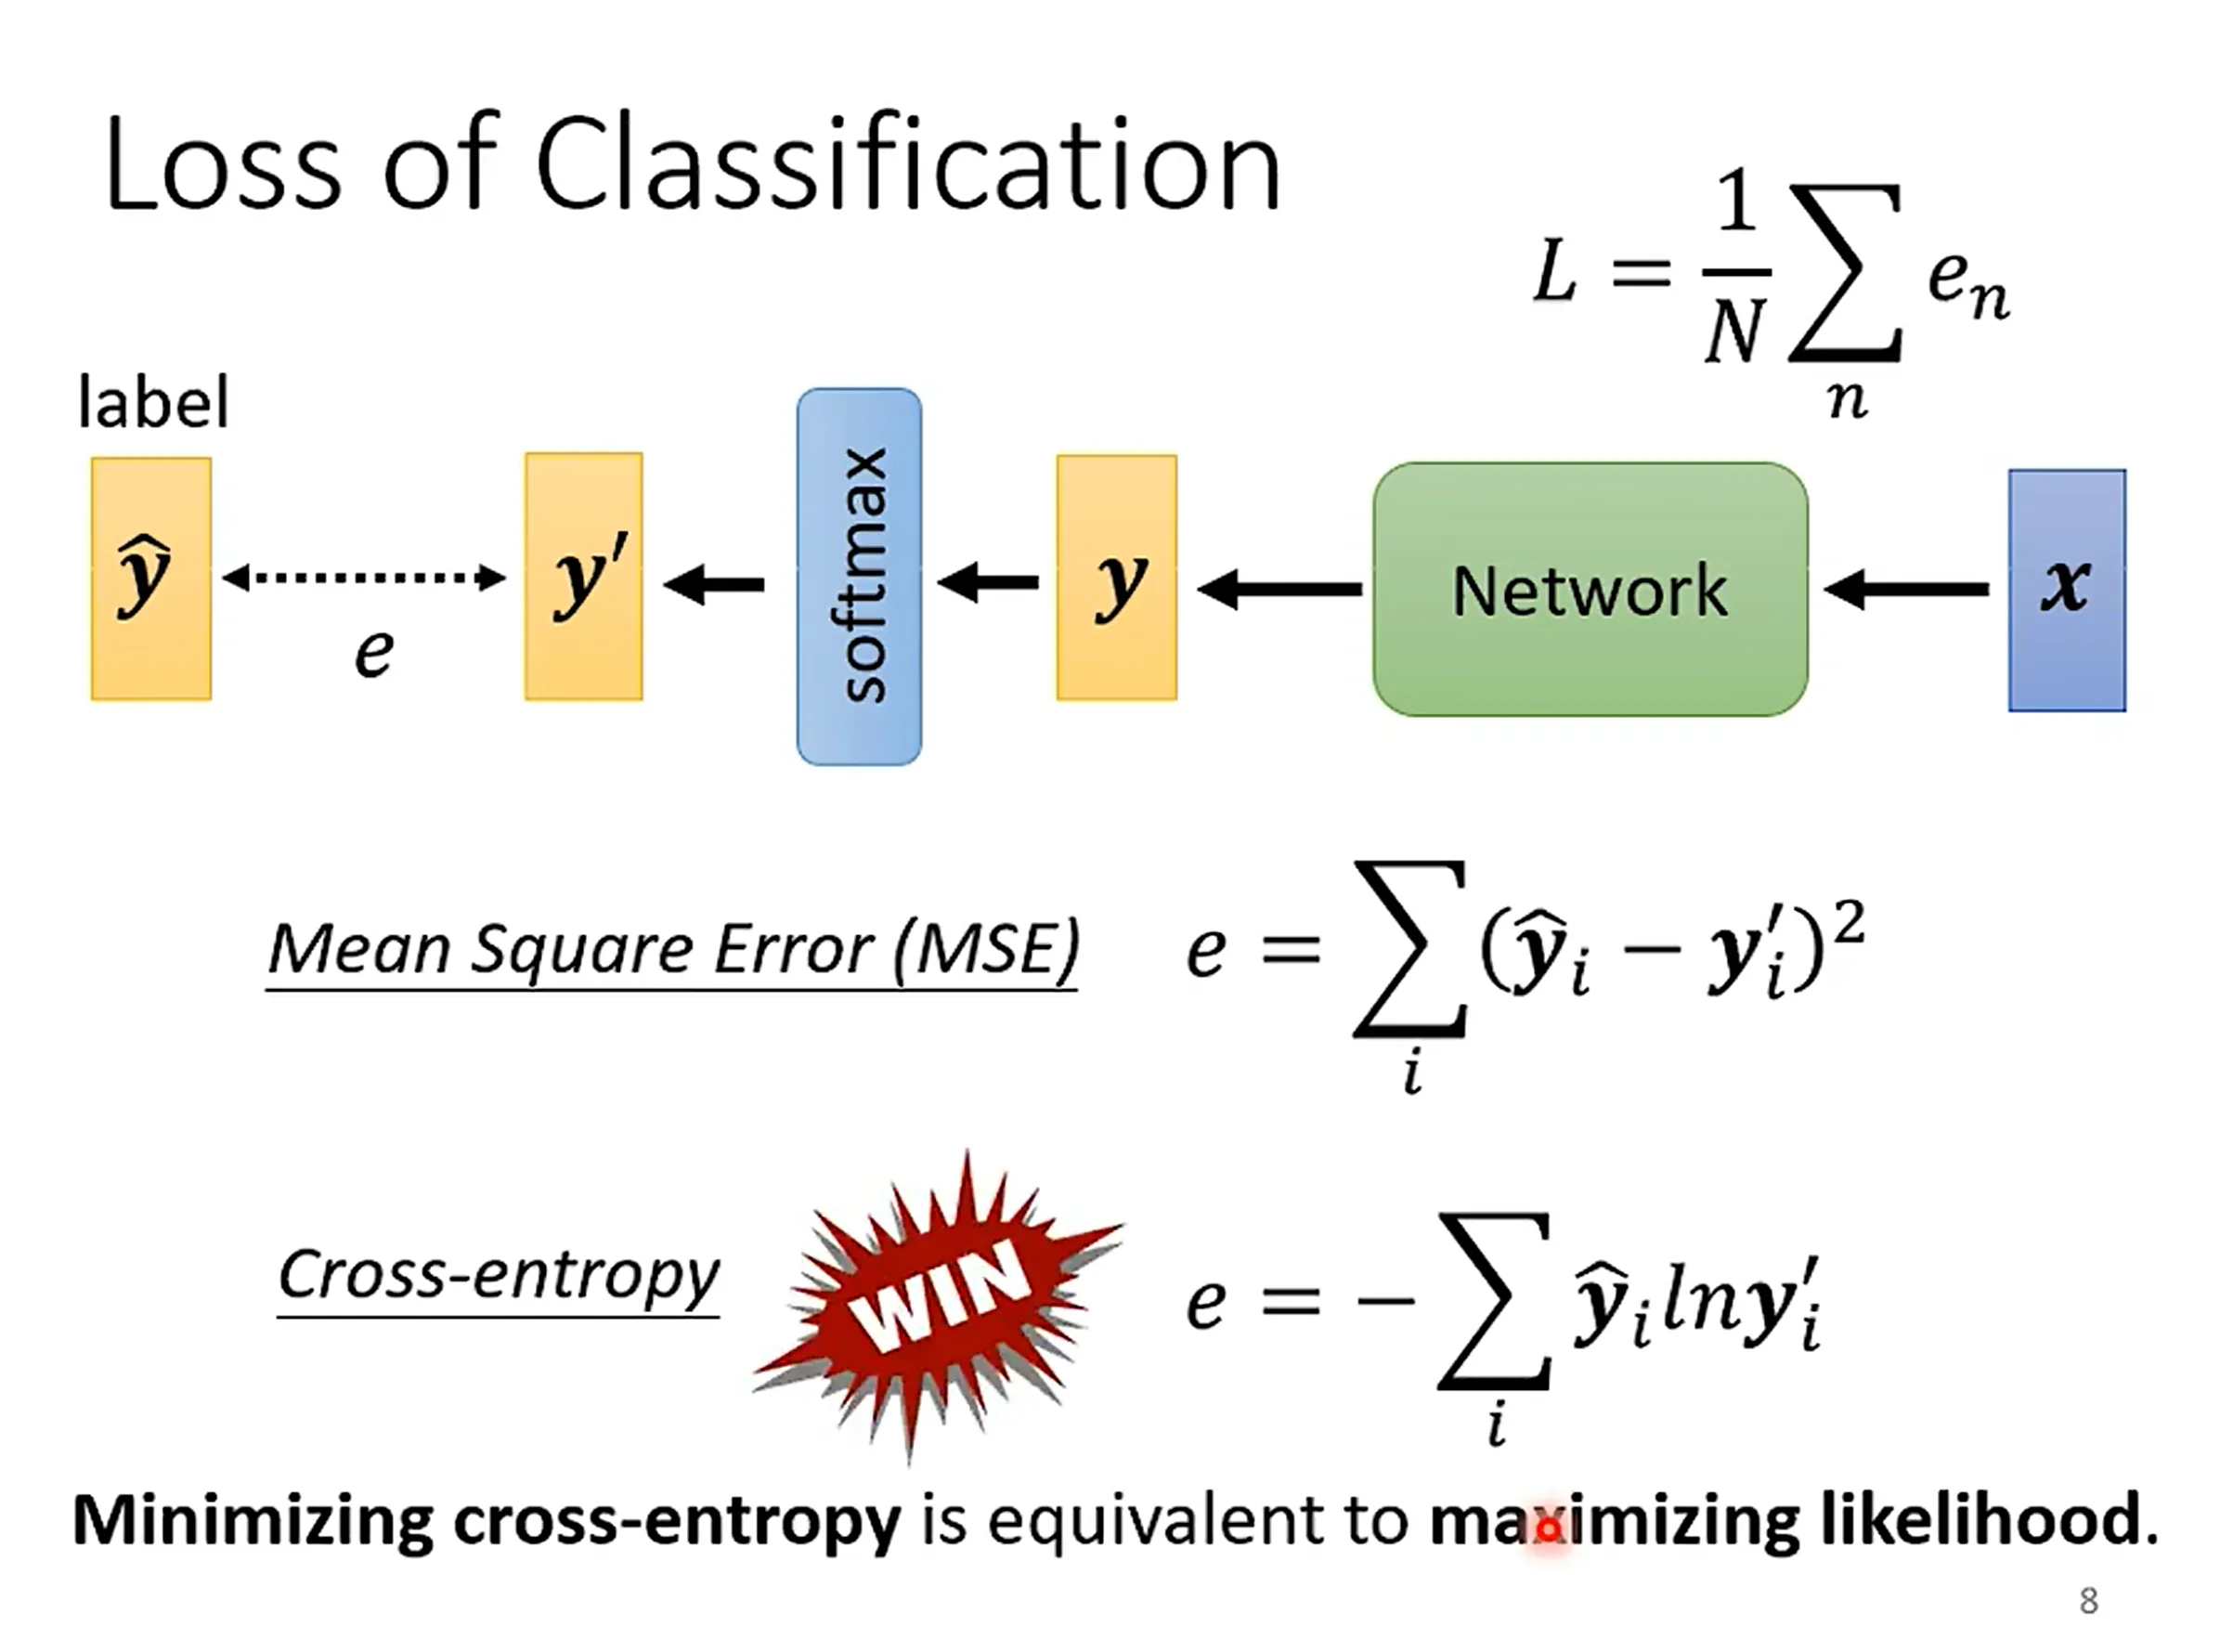
- Softmax 和 Cross-entropy 总是一起的。